7 osobností, které nejvíce posunuly umělou inteligenci
Dnešní LLM vypadají, jako by spadly z nebe někdy v listopadu 2022. Ve skutečnosti stojí na devadesáti letech práce — a překvapivě velkou část z ní odvedla hrstka konkrétních lidí. Vybrali jsme sedm osobností, jejichž objevy tvoří souvislou nit od otázky „co vůbec je výpočet“ až po model, který předpověděl strukturu 200 milionů proteinů. U každé si ukážeme, co přesně dokázala, proč to byl technický zlom, a jak na ni navázali ti další. Nebude to jen výčet jmen a dat — budeme chtít pochopit, proč ty věci fungují.
Proč zrovna těchto sedm
Každý podobný seznam je nutně nespravedlivý, tak na rovinu: kritériem nebyla citovanost ani slavná jména, ale návaznost. Chtěli jsme sedm zastávek, které dohromady vyprávějí jeden příběh: teoretické základy (Turing) → založení oboru (McCarthy) → učicí algoritmus (Hinton) → architektura s vhodnými priory (LeCun) → data jako třetí pilíř (Fei-Fei Li) → škálovatelná architektura (Vaswani a tým Transformeru) → nasazení na skutečné vědecké problémy (Hassabis).
A koho jsme vynechali? Především Yoshuu Bengia — „kmotři deep learningu“ jsou tři a Turingovu cenu za rok 2018 dostal spolu s Hintonem a LeCunem; jeho skupině navíc vděčíme za attention mechanismus, ke kterému se dostaneme u Transformeru. Nemá vlastní kapitolu jen proto, že by se s Hintonem a LeCunem obsahově překrývala. Dále Ilya Sutskever (spoluautor AlexNetu, seq2seq a hlavní vědecká síla za GPT modely), Frank Rosenblatt s perceptronem z roku 1958, Marvin Minsky, Claude Shannon, John von Neumann… A samozřejmě Jürgen Schmidhuber, jehož laboratoř dala světu LSTM — kdybychom ho nezmínili, připomněl by se, jak je jeho zvykem, sám.
Jak článek číst
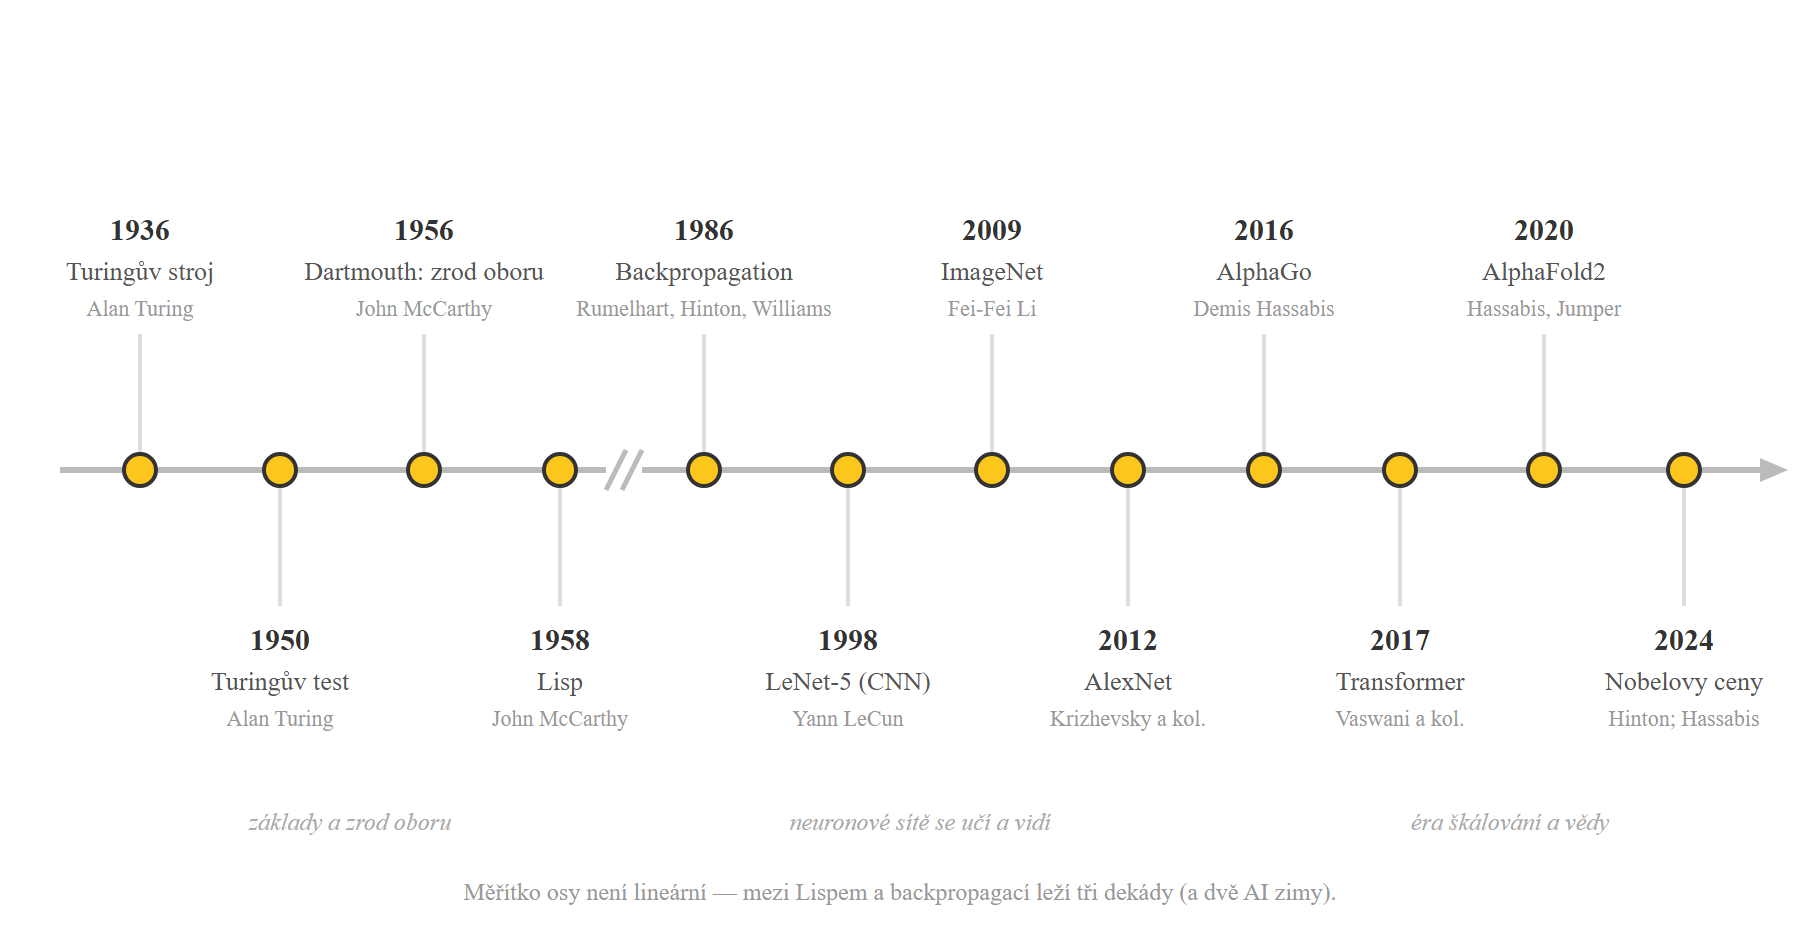
Nejde o žebříček popularity. Berte ho jako technickou mapu: každý člověk přidává do příběhu jednu chybějící vrstvu — výpočet, obor, učení, architekturu, data, škálování a nakonec aplikaci ve vědě.
1. Alan Turing — muž, který definoval výpočet (a zeptal se, zda stroje myslí)
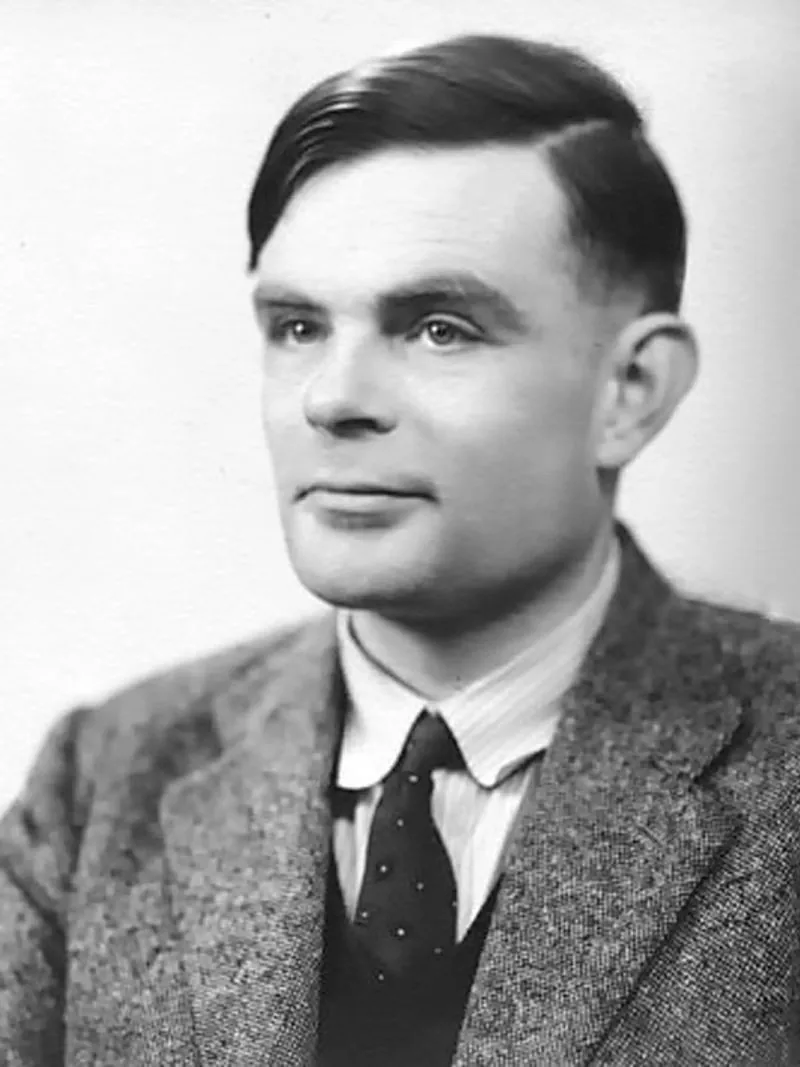
Všechno, co dnes v IT děláme, stojí na článku, který v roce 1936 napsal čtyřiadvacetiletý doktorand v Cambridge. On Computable Numbers, with an Application to the Entscheidungsproblem řešil na první pohled ryze matematickou otázku Davida Hilberta: existuje mechanický postup, který o libovolném matematickém tvrzení rozhodne, zda je dokazatelné? Aby na ni Turing mohl odpovědět (záporně), musel nejdřív formálně definovat, co to znamená „mechanický postup“. Výsledkem je Turingův stroj: nekonečná páska, čtecí hlava a konečná tabulka pravidel.
Zásadní jsou dva důsledky. Zaprvé univerzálnost: Turing ukázal, že existuje jeden konkrétní stroj, který dokáže simulovat libovolný jiný Turingův stroj, pokud jeho popis dostane na pásce jako data. Program je tedy jen další vstup — myšlenka, ze které o dekádu později vyrostla von Neumannova architektura a s ní každý počítač, na kterém tento článek čtete. Zadruhé hranice vyčíslitelnosti: existují dobře definované problémy (halting problem), které žádný algoritmus nevyřeší. Computer science tak vznikla dřív než počítače — včetně svých limitů.
Pro AI je ale stejně důležitý Turingův druhý slavný text. V roce 1950 publikoval v časopise Mind esej Computing Machinery and Intelligence, která začíná větou „I propose to consider the question: Can machines think?“ Protože je otázka špatně definovaná, nahradil ji Turing operačním testem — imitation game, dnes známou jako Turingův test: pokud porotce v textové konverzaci nerozezná stroj od člověka, nemá smysl stroji upírat myšlení. Můžeme o užitečnosti testu diskutovat (dnešní LLM jím v některých studiích procházejí, a přesto halucinují), ale jako reframing to bylo geniální: z metafyzické otázky udělal empirickou.
A ještě jedna věc, která se často přehlíží: v závěru téže eseje Turing navrhuje, že místo programování dospělé mysli bude snazší postavit child machine — jednodušší stroj, který se naučí zbytek sám z dat a zkušenosti. V roce 1950, třicet šest let před backpropagací, tak načrtl základní tezi machine learningu. Turing zemřel v roce 1954, dva roky po odsouzení za homosexualitu; nejprestižnější ocenění v informatice — Turing Award, kterou ACM uděluje od roku 1966 — nese jeho jméno a na této časové ose ji dostanou hned čtyři lidé.
2. John McCarthy — dal oboru jméno a programátorům Lisp
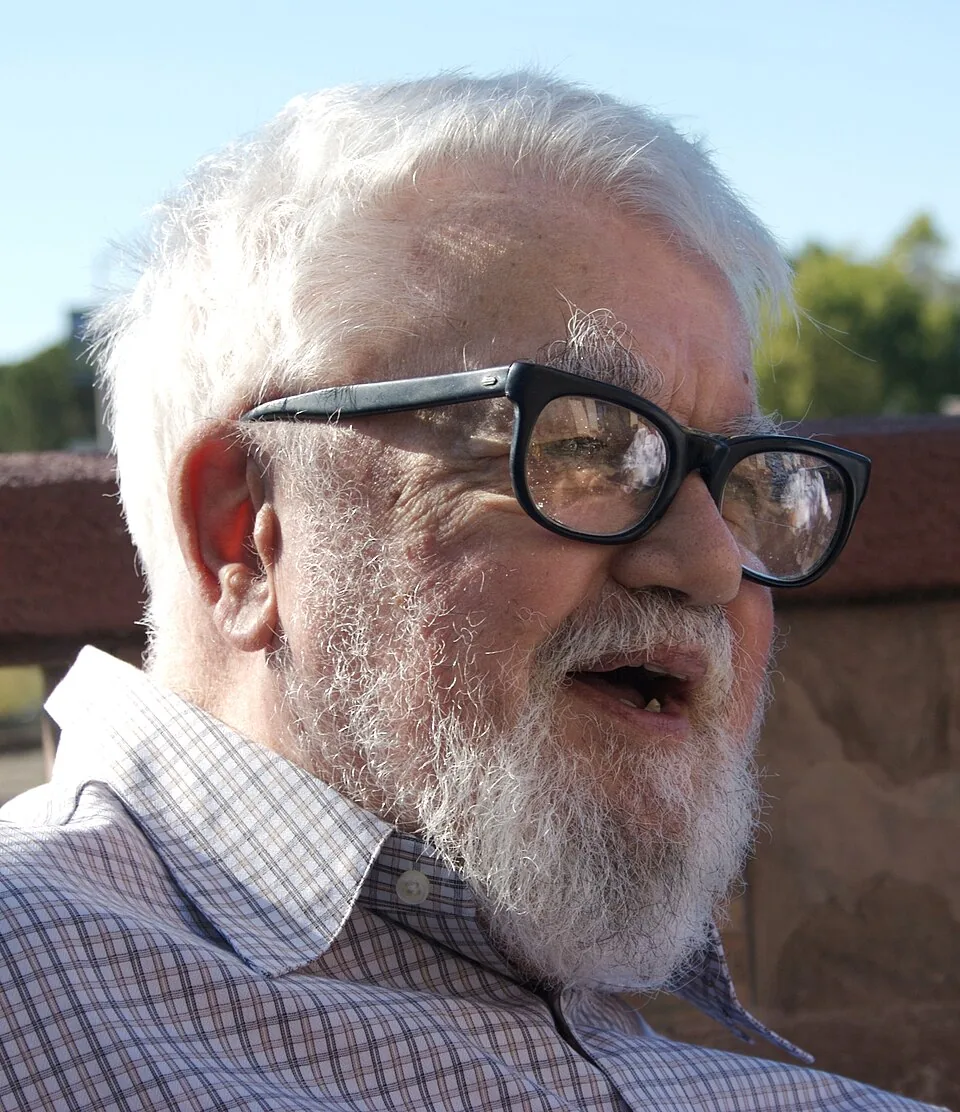
Termín artificial intelligence nevznikl v laboratoři, ale v žádosti o grant. V roce 1955 sepsal John McCarthy s Marvinem Minskym, Nathanielem Rochesterem a Claudem Shannonem návrh letního výzkumného projektu v Dartmouthu, jehož premisa dodnes visí nad celým oborem: „každý aspekt učení nebo jakéhokoli jiného projevu inteligence lze v principu popsat tak přesně, že jej dokáže simulovat stroj.“ Samotný workshop proběhl v létě 1956 a sešla se na něm většina lidí, kteří pak obor dvě dekády formovali. McCarthy zvolil název záměrně — potřeboval obor odlišit od tehdejší kybernetiky (a od jejího dominantního otce Norberta Wienera). Marketing to byl skvělý; s ambicí návrhu („významný pokrok za jedno léto a deset lidí“) se obor potýká dodnes.
Kdyby McCarthy jen vymyslel název, do tohoto výběru by se nedostal. Jenže v roce 1958 navrhl Lisp — jazyk pro symbolické výpočty, který potřeboval pro svůj program Advice Taker (uvažování nad znalostmi zapsanými v logice; myšlenka, ke které se AI vrací v každé generaci, naposledy u znalostních grafů pro agenty). Lisp je po Fortranu druhý nejstarší dodnes používaný vysokoúrovňový jazyk a je těžké přecenit, co všechno v něm bylo poprvé: garbage collection (McCarthy ho vymyslel, protože ruční správa paměti se symbolickými strukturami byla neudržitelná), podmíněné výrazy, rekurze jako základní stavební kámen, funkce jako hodnoty prvního řádu, a především homoikonicita — kód je datová struktura (seznam), takže program může manipulovat s programy. Interaktivní REPL smyčka, kterou dnes máte v Pythonu i v prohlížeči, je také dědictví Lispu.
McCarthy dostal Turingovu cenu v roce 1971, mimo jiné i za prosazení time-sharingu — ideje, že drahý počítač má sloužit mnoha lidem interaktivně a současně. Když si dnes pronajímáte GPU v cloudu (nebo v našem GPU Labu), používáte ekonomický model, který McCarthy obhajoval už v šedesátých letech. Jeho symbolická větev AI — logika, plánování, expertní systémy — sice v osmdesátých letech narazila na strop a přišla AI zima, ale nezmizela: dnešní agenti kombinují neuronový model s explicitními nástroji, plánováním a strukturovanými znalostmi. Jak to vypadá v praxi, rozebíráme v článku Co je AI agent a jak funguje.
3. Geoffrey Hinton — čtyřicet let sázky na neuronové sítě
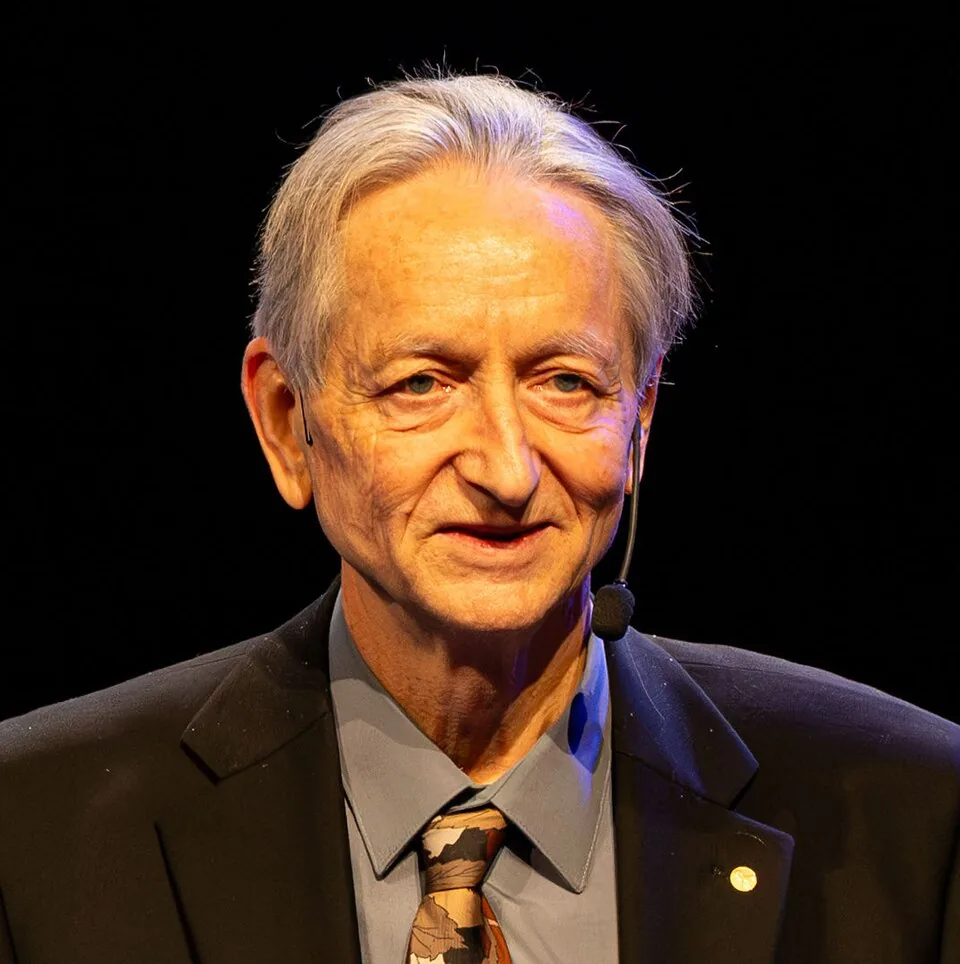
Pokud má tento příběh hlavní postavu, je to Geoffrey Hinton. Psychologa vzděláním fascinovala jediná otázka: jak se mozek učí? A odpověď hledal v době, kdy byly neuronové sítě v akademické klatbě — Minsky a Papert v knize Perceptrons (1969) ukázali, že jednovrstvý perceptron nezvládne ani XOR, a financování na dvě dekády vyschlo. Problém přitom nebyl v konceptu, ale v učení: vícevrstvá síť XOR umí, jenže nikdo nevěděl, jak nastavit váhy skrytých vrstev. Kterému neuronu uprostřed sítě přičíst zásluhu za chybu na výstupu?
Odpovědí je backpropagation. Článek Learning representations by back-propagating errors (Rumelhart, Hinton, Williams, Nature 1986) popsal, jak chybu z výstupu propagovat zpět sítí pomocí řetízkového pravidla pro derivace: gradient loss funkce vůči všem vahám sítě spočítáte jedním zpětným průchodem, tedy za cenu zhruba jednoho dopředného průchodu — místo abyste každou váhu zkoušeli měnit zvlášť. Učení se tím mění na gradient descent ve vysokorozměrném prostoru. Sám algoritmus byl objeven vícekrát nezávisle (Linnainmaa 1970 jako automatická diferenciace, Werbos 1974 — to je ta část, kde má Schmidhuber pravdu), ale až tento článek ukázal, co je skutečně v sázce: síť si ve skrytých vrstvách sama vytváří distribuované reprezentace — vnitřní příznaky, které jí nikdo nenadefinoval. To je přesně ten mechanismus, díky kterému dnes embedding vektory zachycují význam slov (a fungují vektorové databáze).
Následovala další dlouhá zima — v devadesátých letech vyhrávaly SVM a neuronové sítě byly znovu za okrajem. Hinton to nevzdal: v roce 2006 s kolegy ukázal, jak hluboké sítě předtrénovat po vrstvách pomocí restricted Boltzmann machines, a vrátil tím do hry slovo deep. A v roce 2012 přišel moment, kdy se všechno zlomilo: Hintonovi doktorandi Alex Krizhevsky a Ilya Sutskever natrénovali na dvou herních GPU konvoluční síť AlexNet (60 milionů parametrů, ReLU aktivace, dropout) a vyhráli soutěž ImageNet s top-5 chybou 15,3 % proti 26,2 % druhého místa. V oboru, kde se soupeří o desetiny procenta, to nebyl posun, ale demolice — a během dvou let přešel na deep learning celý computer vision.
Hintonův příběh má nezvyklou tečku. V roce 2013 odešel do Googlu (ten koupil jeho tříčlennou firmu DNNresearch), v roce 2019 převzal s LeCunem a Bengiem Turingovu cenu za rok 2018, v květnu 2023 z Googlu odešel, aby mohl svobodně mluvit o rizicích technologie, kterou celý život budoval. A v říjnu 2024 dostal spolu s Johnem Hopfieldem Nobelovu cenu za fyziku — formálně za Boltzmannovy stroje a energetické modely z osmdesátých let, které propojily učení neuronových sítí se statistickou fyzikou. Málokdo v dějinách vědy dostal nejvyšší pocty za práci, kterou mainstream třicet let odmítal.
4. Yann LeCun — konvoluce, aneb architektura je prior
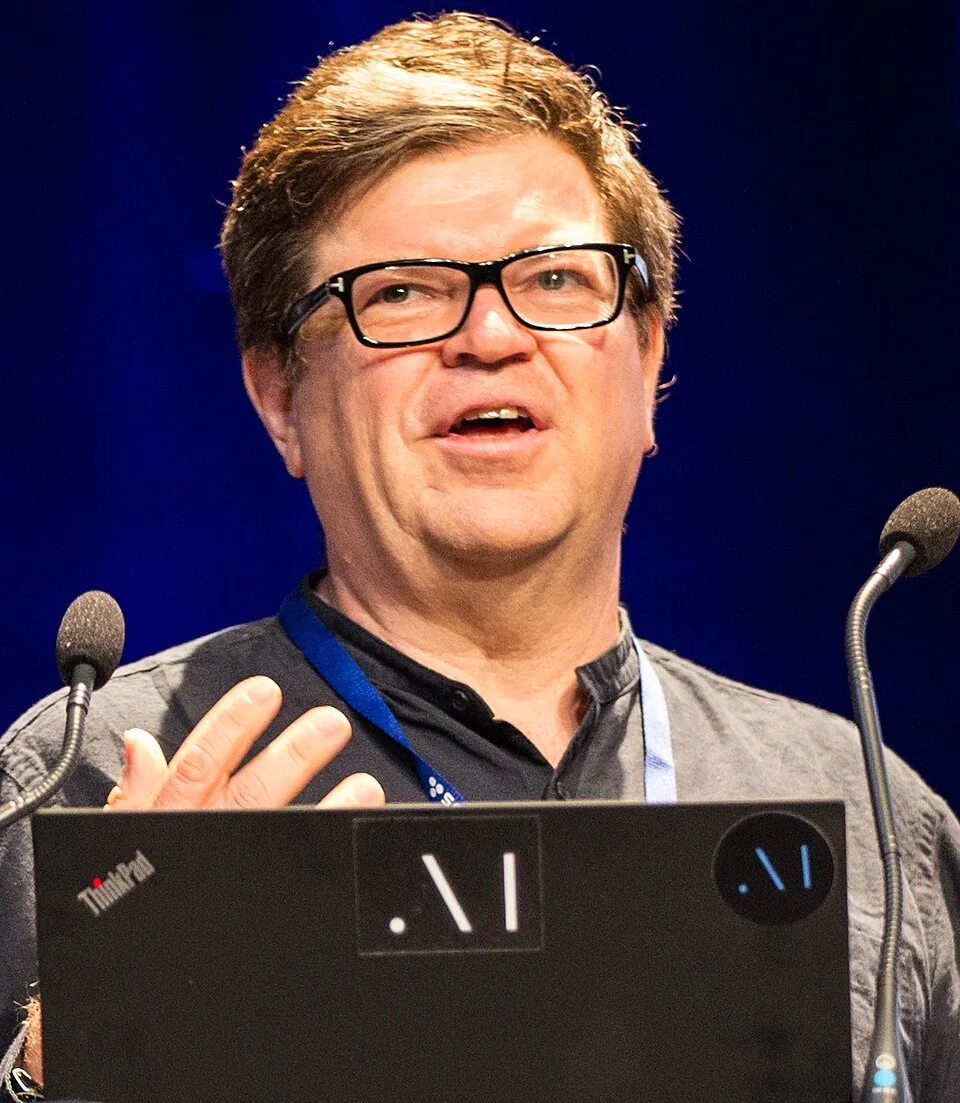
Backpropagation řeší, jak se učit. Yann LeCun vyřešil, co se má učit — tedy jakou strukturu dát síti, aby se učila efektivně. Plně propojená síť pro obrázky je nesmysl: obrázek 224×224 pixelů znamená 150 tisíc vstupů a první vrstva by měla miliardy vah, které se všechny musí naučit totéž (hranu poznáš vlevo nahoře stejně jako vpravo dole). LeCun, který v Hintonově skupině absolvoval postdok, vtělil do architektury dvě pozorování o obrazu: lokalitu (pixel souvisí hlavně se svými sousedy) a translační invarianci (kočka je kočka kdekoli v obraze). Výsledkem je konvoluční síť: malé filtry sdílené napříč celým obrazem, mezi nimi pooling, a hierarchie příznaků od hran přes tvary po objekty. Řádově méně parametrů, řádově lepší generalizace — učebnicový příklad toho, čemu se říká inductive bias.
V Bellových laboratořích to LeCun v roce 1989 poprvé nasadil na rozpoznávání ručně psaných PSČ a v roce 1998 shrnul dekádu práce v článku Gradient-Based Learning Applied to Document Recognition se sítí LeNet-5. Nebyla to akademická hračka: systémy na jejím základě četly v USA na přelomu tisíciletí přes 10 % šeků. Deep learning tedy měl produkční nasazení už v době, kdy tomu nikdo deep learning neříkal. Z téže éry pochází i dataset MNIST, který LeCun spoluvytvořil a na kterém se dodnes učí každý začátečník. AlexNet z předchozí kapitoly je v jádru LeNet — jen hlubší, na GPU a s velkými daty; sám Krizhevsky to tak popisoval.
LeCun je také příklad toho, že vědecká tvrdohlavost nekončí prvním vítězstvím. Od roku 2013 budoval Meta AI (FAIR) a dlouhodobě prosazoval self-supervised learning — učení z dat bez ručních labelů, což je mimochodem přesně princip, kterým se předtrénovávají dnešní LLM (predikce dalšího tokenu žádné anotátory nepotřebuje). Zároveň je nejhlasitějším kritikem představy, že LLM samy o sobě dovedou k obecné inteligenci: argumentuje, že modelu, který se učí jen z textu, chybí model světa — fyzika, kauzalita, plánování. Koncem roku 2025 proto po dvanácti letech opustil Metu a založil startup AMI Labs, zaměřený na world models a architekturu JEPA. V březnu 2026 na tuto sázku získal přes miliardu dolarů. Jestli má pravdu, ukážou až příští roky; jeho dosavadní výsledky ale radí jeho odhady nepodceňovat.
5. Fei-Fei Li — data jsou třetí pilíř
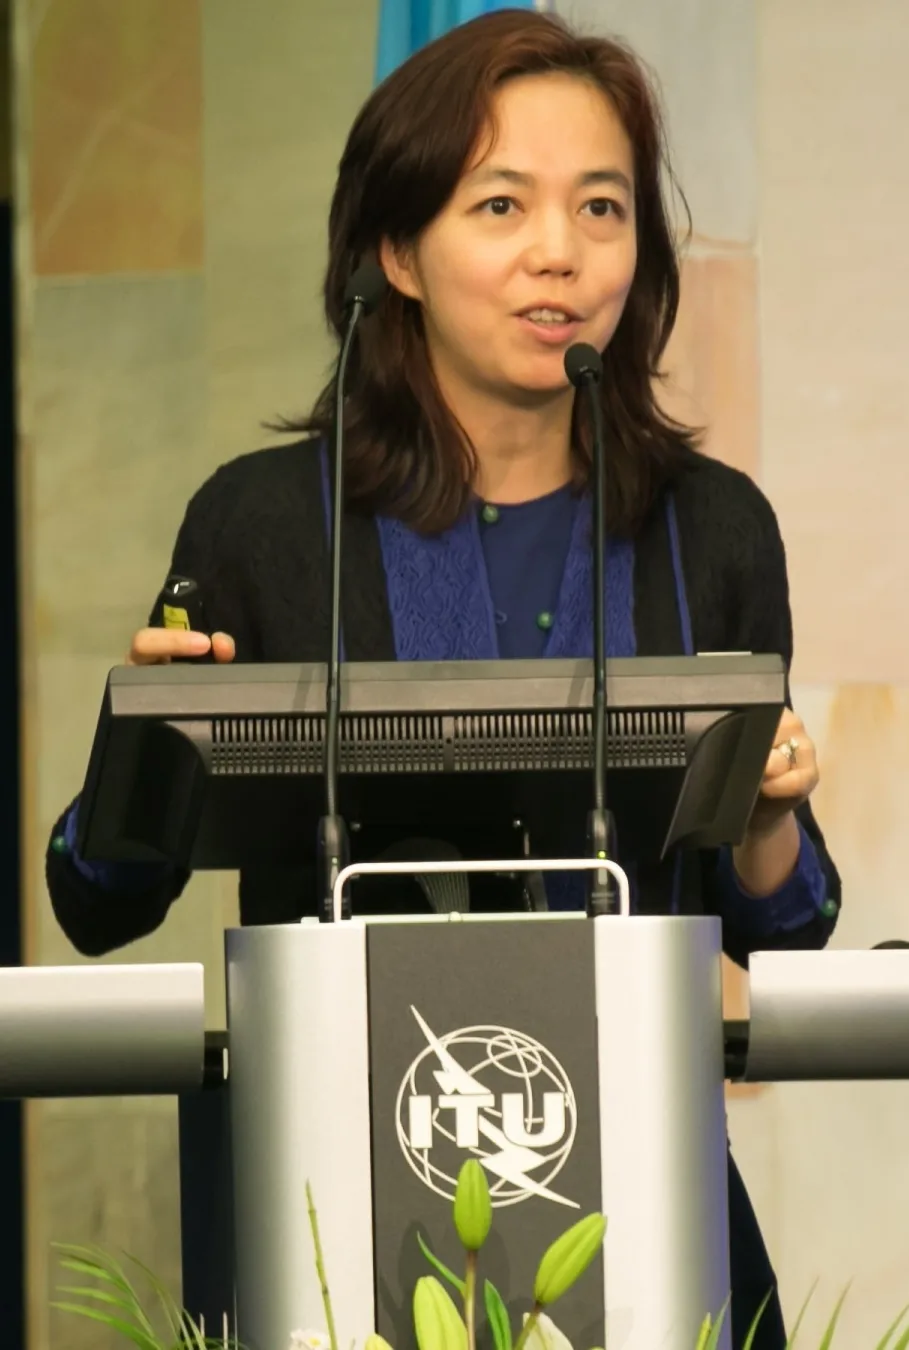
V roce 2006 měl obor učicí algoritmus (backpropagation) i architekturu (CNN), a přesto se počítačové vidění deset let motalo na místě. Fei-Fei Li, tehdy čerstvá profesorka v Princetonu, vyslovila hypotézu, která zněla skoro kacířsky: úzkým hrdlem nejsou modely, ale data. Algoritmy se testovaly na datasetech s desítkami kategorií a tisíci obrázky — dítě přitom do tří let věku „natrénuje“ na stovkách milionů vjemů. Rozhodla se proto zmapovat vizuální svět v měřítku, které do té doby nikoho nenapadlo: projekt ImageNet (CVPR 2009) postavila nad hierarchií pojmů WordNet a naplnila ji nakonec více než 14 miliony ručně ověřených obrázků ve více než 20 tisících kategorií. Anotace zvládla jen díky tehdy nové platformě Amazon Mechanical Turk — crowdsourcing v masovém měřítku byl sám o sobě inženýrský výkon (a předobraz dnešních RLHF anotačních pipeline).
Grantové agentury projekt odmítaly, kolegové jí radili dělat „pořádnou vědu“. Zlomilo se to až díky soutěži ILSVRC (od 2010, podmnožina: 1,2 milionu obrázků, 1000 tříd), která dala oboru společný metr — a v roce 2012 na ní explodoval AlexNet. Tady se nit příběhu svazuje do uzlu: Hintonův algoritmus, LeCunova architektura a data Fei-Fei Li se potkaly s herními GPU a spustily současnou éru AI. Žádná z těch tří složek by sama nestačila; benchmark navíc ukázal, jak brutálně efektivní je společná, veřejná a dostatečně těžká metrika. (O tom, jak se dnes měří kódovací asistenti a proč je to těžší, než to vypadá, píšeme v článku o benchmarcích pro kódovací asistenty.)
Fei-Fei Li bývá označována za „godmother of AI“ a její dráha pokračuje konzistentně: spoluzaložila stanfordský institut Human-Centered AI (HAI) a neziskovku AI4ALL, napsala autobiografii The Worlds I See — a v roce 2024 založila startup World Labs, který sází na to, že další hranicí po jazyku je spatial intelligence: modely, které chápou a generují 3D svět. První produkt Marble (listopad 2025) generuje procházitelné 3D scény z textu či obrázků a firma na vizi počátkem roku 2026 získala miliardu dolarů. Je pozoruhodné, že člověk, který dal AI „oči“ přes data, teď zkouší totéž s prostorem — a že na world models nezávisle vsadil i LeCun.
6. Ashish Vaswani a tým Transformeru — attention místo rekurence
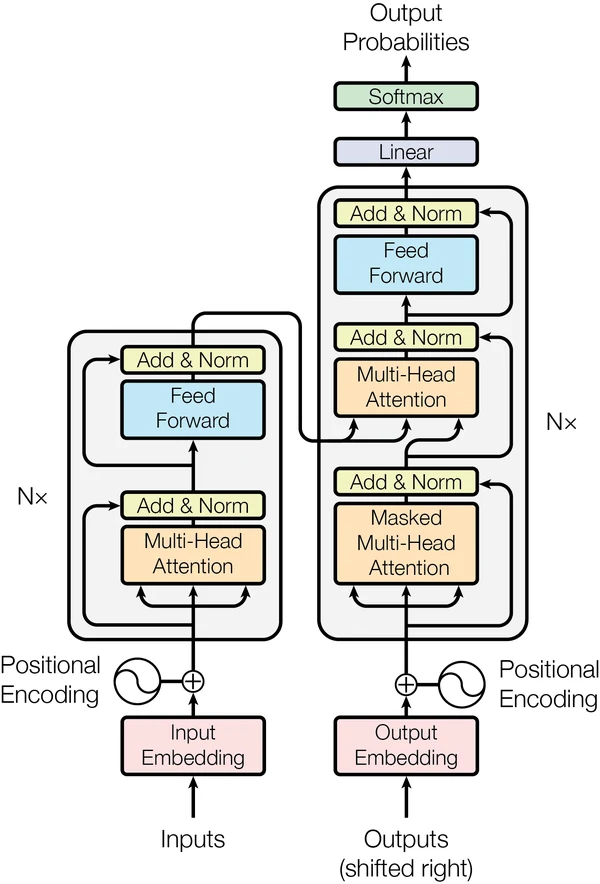
Jediný milník na naší ose, u kterého nestojí jedno jméno, ale osm: Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan Gomez, Łukasz Kaiser a Illia Polosukhin. Jejich článek Attention Is All You Need (červen 2017) je s velkým odstupem nejvlivnější AI publikace dekády — písmeno T v GPT je Transformer.
Kontext: sekvence (text, řeč) se do té doby zpracovávaly rekurentními sítěmi — LSTM četlo větu token po tokenu a významy hromadilo do skrytého stavu. To má dva strukturální problémy. Zaprvé sekvenčnost: krok t nejde spočítat před krokem t−1, takže trénink nelze paralelizovat podél délky sekvence — a GPU, jejichž síla je právě v masivní paralelizaci, se flákají. Zadruhé délka cesty: informace mezi prvním a posledním slovem věty musí projít všemi mezikroky; gradient se po cestě ředí a vztahy na dlouhou vzdálenost se učí špatně. Attention mechanismus, který v roce 2014 zavedli Bahdanau, Cho a Bengio (zase Bengio!), tyhle problémy zmírňoval — ale jen jako přílepek k rekurentní síti.
Radikální krok Transformeru: rekurenci úplně vyhodit a nechat jen attention. Každý token se promítne do tří vektorů — query, key a value — a vztah mezi tokeny se spočítá jako skalární součin query a key (škálovaný a prohnaný přes softmax), kterým se váží values. Všechny dvojice najednou, jedním maticovým násobením:
# jadro self-attention v pseudo-PyTorchi
# X: [delka_sekvence, d_model]
Q = X W_q; K = X W_k; V = X W_v
vahy = softmax(Q K.T / sqrt(d_k))   # [n, n] - kazdy token vs. kazdy token
vystup = vahy V                      # vazeny soucet hodnot
Tím se oba problémy řeší naráz: cesta mezi libovolnými dvěma tokeny má délku 1 (žádné ředění gradientu přes mezikroky) a výpočet je jedno velké maticové násobení — přesně to, co GPU a TPU umí nejlépe. Multi-head attention pak nechá model sledovat několik typů vztahů současně (syntax, koreference, pozici…) a protože samotný attention nemá ponětí o pořadí slov, přidává se positional encoding. Cena za to je kvadratická složitost O(n²) v délce sekvence — důvod, proč se dodnes řeší KV cache, dlouhé kontexty a proč mají LLM potíže typu lost in the middle.
Původní model přitom mířil jen na strojový překlad (WMT 2014, BLEU 28,4 na EN→DE, trénink 3,5 dne na osmi GPU). Zlom nastal, když se ukázalo, že architektura téměř dokonale škáluje: BERT (2018), GPT-2 (2019), GPT-3 (2020) jsou v jádru pořád tentýž blok, jen větší a s více daty. Dnes Transformer pohání i vision modely, generování obrázků či AlphaFold. A osudy autorů ilustrují gravitaci té práce: všech osm z Googlu odešlo a stojí za firmami jako Cohere (Gomez), Sakana AI (Jones), Character.AI (Shazeer), Essential AI (Vaswani) nebo NEAR Protocol (Polosukhin); Kaiser je v OpenAI, Parmar v Anthropicu. Jeden článek, půlka dnešního AI ekosystému.

7. Demis Hassabis — od hry Go k Nobelově ceně za chemii
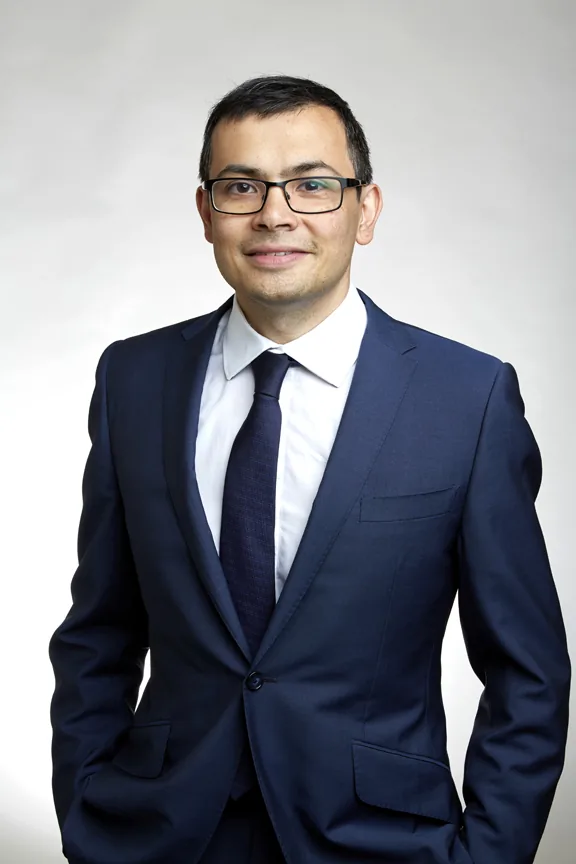
Životopis Demise Hassabise vypadá jako připravovaný plán: šachový velmistr v zácviku (ve 13 letech druhý nejvýše hodnocený hráč světa do 14 let), v sedmnácti spoluautor herního hitu Theme Park, pak vlastní herní studio, doktorát z kognitivní neurovědy na UCL zaměřený na paměť a imaginaci — a v roce 2010 založení DeepMind se Shanem Leggem a Mustafou Suleymanem, s explicitní misí „vyřešit inteligenci a pak s ní vyřešit všechno ostatní“. Google firmu koupil v roce 2014 za stovky milionů dolarů, když ještě neměla žádný produkt — jen demo, ve kterém se jedna síť naučila hrát desítky her Atari z pouhých pixelů a skóre (deep Q-network, publikováno v Nature 2015 — první velké spojení deep learningu s reinforcement learningem).
Světovou událostí se stal březen 2016: AlphaGo porazilo 4:1 Lee Sedola, jednoho z nejlepších hráčů Go v historii. Go bylo považováno za dekádu vzdálenou metu — prohledávací strom je řádově větší než u šachů a chybí jednoduchá vyhodnocovací funkce. AlphaGo zkombinovalo tři složky: policy síť (navrhuje slibné tahy), value síť (odhaduje, kdo pozici vyhraje) a Monte Carlo tree search, který jimi řídí prohledávání; učilo se nejprve z lidských partií a poté hraním proti sobě. Slavný 37. tah druhé partie — tah, který by podle policy sítě zahrál člověk s pravděpodobností 1 : 10 000 a který komentátoři zprvu považovali za chybu — se stal symbolem stroje, který nejen napodobuje, ale objevuje. Nástupce AlphaGo Zero (2017) se pak lidských dat zbavil úplně: začal od náhodných vah a jen z pravidel hry se za pár dní dostal nad úroveň původního systému. Čistá lekce o síle self-play RL — a předzvěst dnešního trendu, kdy se agentní chování modelů tréninkem přes reinforcement learning teprve dolaďuje.
Kdyby Hassabis skončil u her, byl by to skvělý inženýrský příběh. Jenže hry pro něj byly vždy jen benchmark. V roce 2020 AlphaFold2 v soutěži CASP14 de facto vyřešil 50 let starý problém predikce 3D struktury proteinu z aminokyselinové sekvence: mediánová přesnost kolem 90 GDT je srovnatelná s experimentálními metodami, které stojí měsíce práce a peněz. Architektonicky je to mimochodem opět attention — Evoformer zpracovává zarovnání příbuzných sekvencí a mapu párových vzdáleností. DeepMind následně s EMBL-EBI zveřejnil predikce struktur přes 200 milionů proteinů — prakticky všech, které věda zná — a v říjnu 2024 za to Hassabis s Johnem Jumperem dostali polovinu Nobelovy ceny za chemii (druhou polovinu David Baker za návrh nových proteinů). Dvě Nobelovy ceny za AI v jednom týdnu roku 2024 — Hintonova za fyziku a tato za chemii — jsou asi nejjasnější signál, že se AI přestala měřit jen sama na sobě a začala měnit ostatní vědy. Hassabis dnes jako CEO Google DeepMind vede mimo jiné vývoj modelů Gemini.
Nit, která příběh spojuje
Zkusme těch sedm zastávek přečíst najednou. Turing dokázal, že výpočet je univerzální médium, a navrhl učení jako cestu k inteligenci. McCarthy dal oboru jméno, jazyk a první paradigma — symbolické uvažování. Hinton (s Rumelhartem, Williamsem a po boku Bengia) dodal učicí algoritmus, LeCun ukázal, že architektura musí odpovídat struktuře dat, a Fei-Fei Li doložila, že bez dat v odpovídajícím měřítku je obojí k ničemu. Když se v roce 2012 tyto tři složky potkaly s výkonem herních GPU, vznikl AlexNet. Transformer pak odstranil poslední překážku škálování — sekvenčnost — a Hassabis předvedl, že totéž strojové učení, které vyhrává hry, umí produkovat vědecké poznání, za které se udělují Nobelovy ceny.
Vzorec, který se opakuje pozoruhodně často: průlom nastane, když se potká myšlenka (často dekády stará), data v dostatečném měřítku a hardware, který to utáhne. Backpropagation čekala na svůj moment 26 let. Konvoluční sítě 23 let. Attention „jen“ tři roky. A druhá půlka vzorce: skoro každý z těch objevů byl v době svého vzniku proti proudu — neuronové sítě v klatbě, ImageNet bez grantů, sázka na Go „o dekádu dřív“. Konsenzus oboru se v AI historicky mýlil tak často, že dnešní sebejisté predikce (jakýmkoli směrem) je zdravé číst s rezervou.
Co si z toho odnést jako vývojář
- Čtěte primární zdroje. Attention Is All You Need má 11 stran a přečtete ji za večer; pochopení Q/K/V matic vám pak vysvětlí půlku provozních vlastností LLM — od KV cache po U-křivku pozornosti.
- Data jsou produkt, ne příloha. Lekce Fei-Fei Li platí i pro váš RAG systém nebo evaluaci agenta: pečlivě postavený dataset a metrika často přinesou víc než výměna modelu.
- Architektura = zakódované předpoklady. CNN vyhrála, protože odpovídala struktuře obrazu; Transformer, protože odpovídal struktuře hardwaru. Když navrhujete systém, ptejte se, jaké struktuře odpovídá on.
- Škálování má strukturální příčiny, ne magické. Transformer neškáluje proto, že je „chytřejší“, ale protože odstranil sekvenční závislosti. Podobné uvažování se hodí u každé distribuované architektury.
- Staré myšlenky se vracejí. Symbolika McCarthyho žije v tool callingu a znalostních grafech, reinforcement learning z AlphaGo v post-tréninku dnešních modelů. Vyplatí se znát historii — šetří to slepé uličky.
Chcete na ramenou těchhle obrů stavět, ne jen číst?
Na kurzu Programátor AI agentů projdeme celou moderní vrstvu prakticky: od toho, jak Transformer a LLM fungují uvnitř, přes tool calling a RAG až po stavbu vlastních agentů. Základy strojového učení a LLM pokrývá i Umělá inteligence pro programátory, vědu a datovou analytiku. A pokud si chcete modely osahat na vlastním železe, máme pro vás GPU Lab.
Zdroje a další čtení
- A. Turing: On Computable Numbers (1936) — Turingův stroj a hranice vyčíslitelnosti
- A. Turing: Computing Machinery and Intelligence (1950) — imitation game a learning machines
- McCarthy, Minsky, Rochester, Shannon: A Proposal for the Dartmouth Summer Research Project on AI (1955)
- Rumelhart, Hinton, Williams: Learning representations by back-propagating errors (Nature, 1986)
- Krizhevsky, Sutskever, Hinton: ImageNet Classification with Deep CNNs (2012) — AlexNet
- LeCun a kol.: Gradient-Based Learning Applied to Document Recognition (1998) — LeNet-5
- Deng, Dong, Socher, Li, Li, Fei-Fei: ImageNet: A Large-Scale Hierarchical Image Database (CVPR 2009)
- Vaswani a kol.: Attention Is All You Need (2017)
- Jumper a kol.: Highly accurate protein structure prediction with AlphaFold (Nature, 2021)
- ACM: Fathers of the Deep Learning Revolution Receive Turing Award (2019)
- Nobelova cena za fyziku 2024 (Hopfield, Hinton) a za chemii 2024 (Baker, Hassabis, Jumper)
- Fei-Fei Li: The Worlds I See (2023) — autobiografie o vzniku ImageNetu
