Co je embedding: jak AI převádí význam na čísla
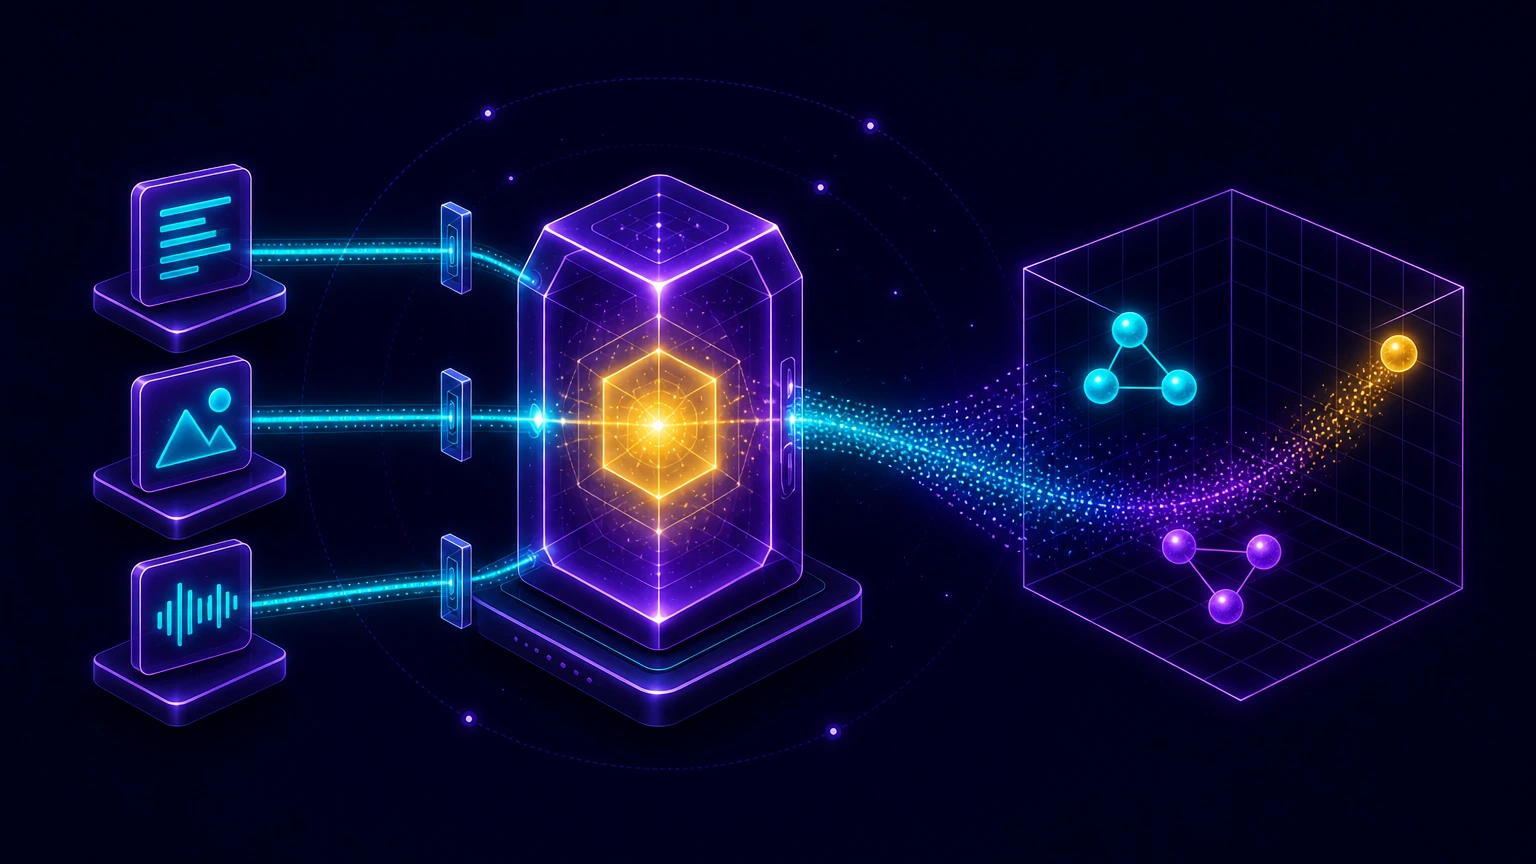
Když do vyhledávání napíšete „kurz AI pro začátečníky“, očekáváte i výsledky s názvem „úvod do umělé inteligence“. Slova se neshodují, význam ano. Embedding převádí text, obrázek nebo jiný objekt na číselný vektor, ve kterém lze takovou významovou podobnost spočítat.
Co je embedding
Embedding, česky také vektorová reprezentace nebo vektorové vnoření, je zobrazení objektu do prostoru čísel. Vstupem může být slovo, věta, celý dokument, fotografie, zvuk, produkt, uživatel nebo třeba uzel grafu. Výstupem je uspořádaný seznam čísel pevné délky:
Samotná hodnota 0.18 obvykle neznamená „umělá inteligence“ a −0.42 neznamená „začátečník“. Informaci nese až celý vektor a jeho poloha vůči ostatním vektorům vytvořeným stejným modelem.
Klíčová vlastnost zní: objekty, které model podle svého tréninku považuje za podobné, se ocitnou blízko sebe. Embedding věty „základy Pythonu“ proto může být blíž větě „programování v Pythonu pro začátečníky“ než větě „péče o ovocné stromy“. Nejde však o obecnou definici významu. Jde o reprezentaci naučenou z dat a cíle konkrétního modelu.
Proč AI potřebuje vektory
Neuronová síť nepracuje přímo se slovy ani obrázky. Její vrstvy násobí matice, sčítají čísla a používají nelineární funkce. Vstup proto musí dostat číselnou podobu. Nejjednodušší možností pro slova je one-hot encoding: každé slovo má dlouhý vektor plný nul a jednu jedničku na vlastní pozici.
Takové kódování rozliší slova, ale nezachytí jejich vztah. Vektory slov „pes“ a „štěně“ jsou stejně vzdálené jako „pes“ a „databáze“. Navíc mají tolik rozměrů, kolik je položek ve slovníku, a většina hodnot je nulová.
Embedding je oproti tomu hustý vektor: má výrazně méně rozměrů a téměř všechny hodnoty nesou část informace. Jeho souřadnice se model naučí tak, aby byly užitečné pro zvolenou úlohu. U textu to často znamená, že výrazy používané v podobných kontextech dostanou podobné reprezentace.
Embedding není „porozumění“ v lidském smyslu
Vektor zachycuje statistickou strukturu naučenou z dat. To může být pro hledání a klasifikaci mimořádně užitečné, ale neznamená to, že model rozumí zkušenosti, záměru nebo pravdivosti stejně jako člověk.
Jak embedding vzniká
Přesný postup závisí na architektuře a tréninku. U moderního textového embeddingového modelu lze zjednodušeně popsat čtyři kroky:
- Tokenizace. Text se rozdělí na tokeny — celá slova, části slov, interpunkci nebo jiné jednotky. České slovo může tvořit jeden i několik tokenů.
- Počáteční reprezentace. Každý token získá vstupní vektor z naučené embeddingové tabulky. Přidá se informace o pořadí či pozici.
- Kontextualizace. Vrstvy Transformeru promění reprezentaci každého tokenu podle okolního textu. Slovo „zámek“ proto může mít jiný kontextový stav ve větě o dveřích a jiný ve větě o historické budově.
- Sloučení do jednoho vektoru. Model použije pooling nebo speciální naučený výstup, aby z proměnlivě dlouhého textu vytvořil vektor pevné délky. Model určený pro podobnost je na tento krok cíleně trénovaný.
Poslední bod je důležitý. Ne každý jazykový model automaticky vytváří kvalitní embedding celých vět. Například prosté zprůměrování libovolných skrytých stavů Transformeru nemusí dát prostor vhodný pro sémantické porovnávání. Model má být trénovaný nebo doladěný právě pro retrieval, podobnost či jinou zamýšlenou úlohu.
Co se model při tréninku učí
Starší word2vec se učil předpovídat slovo z okolního kontextu nebo naopak kontext z daného slova. Moderní embeddingové modely často používají kontrastivní učení: dostanou dvojice, které k sobě patří, a obtížné negativní příklady, které vypadají podobně, ale správnou odpovědí nejsou. Cílem je přiblížit relevantní dvojice a oddálit nerelevantní.
U vyhledávání může být pozitivní dvojicí otázka a odstavec s odpovědí. Negativním příkladem je odstavec na podobné téma, který však otázku nezodpovídá. Volba tréninkových dvojic proto přímo ovlivňuje, co bude později znamenat „blízko“.
Vektorový prostor jako mapa významů
Každý embedding lze chápat jako bod ve vícerozměrném prostoru. Dvourozměrná mapa níže je pouze ilustrace: skutečný model může používat stovky nebo tisíce dimenzí a při převodu do dvou rozměrů se část vztahů ztratí.
Co je dimenze embeddingu
Dimenze je počet čísel ve vektoru. Vektor délky 384 má 384 dimenzí. Více dimenzí může modelu dát větší kapacitu, ale automaticky neznamená lepší výsledky. Zvyšuje také velikost úložiště, množství přenášených dat a cenu porovnávání.
Hrubý odhad pro nekomprimované hodnoty float32 je počet vektorů × dimenze × 4 bajty. Milion vektorů o 768 dimenzích zabere přibližně 3,1 GB jen pro souřadnice. Metadata, databázový index, replikace a provozní režie se přidávají navíc.
Jak se měří podobnost embeddingů
Jakmile máme dva vektory, potřebujeme číslo vyjadřující jejich blízkost. Nejčastěji se používá kosinová podobnost, skalární součin nebo eukleidovská vzdálenost. Správná volba závisí na tom, jak byl model trénovaný a co doporučuje jeho dokumentace.
U kosinové podobnosti bývá hodnota 1 maximální shoda směru, 0 kolmost a −1 opačný směr. V praxi však neexistuje univerzální hranice typu „nad 0,8 je text relevantní“. Rozdělení skóre závisí na modelu, jazyku, datech i typu dotazu. Hranici je nutné odvodit z vlastního testovacího souboru, případně pracovat s pořadím nejlepších výsledků top-k.
Zjednodušený číselný příklad
Představme si pouze tři dimenze. Dotaz má normalizovaný vektor q = [0.8, 0.6, 0]. Dokument A má a = [0.75, 0.66, 0] a dokument B b = [0.1, 0.2, 0.97]. Skalární součin dotazu s A je výrazně vyšší, proto A skončí před B. Skutečný model dělá stejný druh výpočtu ve stovkách dimenzí; čísla v příkladu nejsou výstupem konkrétního modelu.
Jaké typy embeddingů existují
Symetrické a asymetrické vyhledávání
Při symetrické podobnosti porovnáváme objekty stejného typu, například dvě parafráze. Při asymetrickém retrievalu je krátká otázka porovnávána s delším odstavcem obsahujícím odpověď. Některé modely vyžadují pro dotaz a dokument odlišný prefix nebo samostatnou kódovací metodu. Ignorování tohoto pokynu může kvalitu výrazně snížit.
Praktický příklad: sémantické hledání v Pythonu
Následující malý příklad používá lokální vícejazyčný model ze Sentence Transformers. Dokumenty i dotaz normalizujeme, takže maticové násobení odpovídá kosinové podobnosti. Model je vhodný pro názornou ukázku; pro produkci porovnejte více modelů na vlastních českých datech.
from sentence_transformers import SentenceTransformer
import numpy as np

model = SentenceTransformer(
    "sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2"
)

dokumenty = [
    "Kurz vysvětluje základy Pythonu úplným začátečníkům.",
    "Neuronové sítě se učí z trénovacích dat.",
    "Fakturu pošleme po přijetí objednávky.",
    "Do umělé inteligence můžete vstoupit i bez předchozí praxe.",
]

vektory = model.encode(
    dokumenty,
    normalize_embeddings=True,
)

dotaz = "Jak začít s AI, když nemám zkušenosti?"
vektor_dotazu = model.encode(
    dotaz,
    normalize_embeddings=True,
)

skore = vektory @ vektor_dotazu
poradi = np.argsort(skore)[::-1]

for index in poradi[:3]:
    print(f"{skore[index]:.3f}  {dokumenty[index]}")
Výstup seřadí texty podle podobnosti s dotazem. Přesné skóre se může změnit s verzí modelu a knihovny. Podstatné je pořadí: věta o vstupu do AI by měla být výše než věta o faktuře, i když dotaz nepoužívá stejnou formulaci.
Pro několik tisíc položek lze podobnost spočítat přímo v NumPy. U milionů vektorů se používá specializovaný index pro přibližné hledání nejbližších sousedů.
Od embeddingu k sémantickému vyhledávání
Vektorová databáze ukládá embedding spolu s identifikátorem původního textu a metadaty, například jazykem, typem dokumentu, datem nebo oprávněním uživatele. Na dotaz vrátí nejbližší vektory. Původní obsah se obvykle načte podle uloženého identifikátoru.
Pro rychlé hledání ve velké kolekci se používají indexy pro Approximate Nearest Neighbor (ANN). Známým příkladem je HNSW, který organizuje vektory do vícevrstvého grafu. Vyhledávání nemusí procházet každý bod, ale cenou za rychlost je možnost, že některého skutečně nejbližšího souseda nenajde. Parametry indexu proto vyvažují rychlost, paměť a recall.
Podrobnější pohled na úložiště, metadata a indexování najdete v článku Co je vektorová databáze a jak ji používají AI agenti.
Kdy samotné embeddingy nestačí
Sémantické hledání může přehlédnout přesný kód produktu, číslo smlouvy, neobvyklou zkratku nebo nové vlastní jméno. Fulltextové vyhledávání je naopak silné v přesné shodě slov. Produkční systémy proto často používají hybridní vyhledávání: spojí lexikální skóre, například BM25, s vektorovou podobností a výsledky znovu seřadí.
Další krok představuje reranker. Levný embeddingový index rychle vybere například 50 kandidátů a přesnější model, který vidí dotaz společně s každým kandidátem, z nich sestaví finální pořadí. Tím se oddělí rychlé vyhledání kandidátů od dražšího posouzení relevance.
Jak embeddingy fungují v RAG
RAG neboli Retrieval-Augmented Generation propojuje vyhledávání s generativním modelem. Embeddingy v něm často zajišťují první část — retrieval:
- Dokumenty se rozdělí na menší úryvky neboli chunky.
- Každý úryvek dostane embedding a uloží se do indexu.
- Uživatelský dotaz se převede na vektor stejným modelem.
- Systém najde relevantní úryvky, případně je filtruje a znovu seřadí.
- Vybrané texty vloží do kontextu jazykového modelu.
- Model vytvoří odpověď a ideálně uvede zdroje.
Embedding tedy odpověď negeneruje. Pomáhá rozhodnout, které podklady má generativní model dostat. Pokud retrieval vybere špatné dokumenty, ani silný jazykový model z nich spolehlivou odpověď nevytvoří.
Chunking: jak velký text vložit do jednoho vektoru
Celý dlouhý manuál lze technicky převést na jeden vektor jen u modelu, který takovou délku přijme. Pro vyhledávání to však bývá špatné: několik témat se slije do jedné reprezentace a vrácený dokument je příliš dlouhý. Příliš malé úryvky zase ztratí kontext.
- Dělte podle struktury. Nadpisy, odstavce, seznamy a sekce často dávají lepší hranice než pevný počet znaků.
- Zachovejte identitu. K úryvku přidejte název dokumentu, nadřazený nadpis, URL a verzi.
- Překryv používejte střídmě. Může chránit věty na hranici, ale vytváří duplicity a zvyšuje náklady.
- Filtrujte metadata před hledáním, když je to bezpečnostní podmínka. Uživatel nesmí dostat cizí dokument jen proto, že je významově podobný.
Varianty RAG od jednoduchého vyhledávání po GraphRAG a agentní řízení porovnává článek Typy RAG: od základního vyhledávání po GraphRAG a AI agenty.
Kde se embeddingy používají
- Sémantické vyhledávání: najde obsah podle významu, ne jen podle shody slov.
- Doporučovací systémy: propojí uživatele s podobnými produkty, filmy, hudbou nebo kurzy.
- Seskupování: odhalí témata v zákaznických dotazech, recenzích nebo dokumentech bez ručně připravených kategorií.
- Klasifikace: embedding poslouží jako vstup pro jednodušší model nebo se nový text přiřadí k nejbližším známým příkladům.
- Deduplikace a detekce parafrází: odhalí téměř stejný obsah, i když je přeformulovaný.
- Detekce anomálií: neobvykle vzdálené body mohou signalizovat nový typ požadavku nebo chybu v datech.
- AI agenti: embeddingy pomáhají hledat v paměti, dokumentaci a katalogu nástrojů. Samotnou agentnost však nevytvářejí; více vysvětluje článek Co je AI agent a jak funguje.
Omezení a časté chyby
Technické detaily, které se snadno přehlédnou
- Dodržujte maximální délku vstupu modelu a sledujte skutečný počet tokenů.
- Pro dokumenty a dotazy používejte přesně stejné předzpracování, verzi modelu a doporučený formát vstupu.
- Ukládejte identifikátor modelu, dimenzi, verzi chunkingu a hash zdrojového textu. Bez nich se index obtížně reprodukuje.
- Po změně dokumentu přegenerujte všechny dotčené úryvky a odstraňte staré vektory. Jinak bude systém vracet neaktuální obsah.
- Nezaměňujte podobnost za finální pořadí. Jazyk, čerstvost, autorita zdroje a oprávnění mohou mít stejnou nebo větší váhu.
Jak poznat, že embeddingové vyhledávání funguje
Pět přesvědčivých ukázek nestačí. Potřebujete testovací sadu skutečných dotazů a pro každý z nich označené relevantní dokumenty. Ideálně zahrne krátké i dlouhé dotazy, češtinu bez diakritiky, přesné identifikátory, synonyma, nejasné otázky i případy, pro které správný dokument neexistuje.
V produkci doplňte anonymizovanou zpětnou vazbu a pravidelně vzorkujte neúspěšné dotazy. Distribuce dotazů se mění a index, který fungoval při spuštění, může po měsících zaostávat.
Časté otázky o embeddingu
Co si odnést
- Embedding převádí text, obrázek nebo jiný objekt na vektor pevné délky.
- Blízkost vektorů vyjadřuje podobnost naučenou konkrétním modelem.
- Vektory lze porovnávat kosinovou podobností, skalárním součinem nebo vzdáleností podle doporučení modelu.
- Embeddingy pohánějí sémantické vyhledávání, doporučování, klasifikaci, seskupování a retrieval v RAG.
- Kvalitu systému neurčuje jen model, ale také chunking, metadata, hybridní hledání, reranking, oprávnění a evaluace.
- Podobnost není pravda a embedding není šifrování ani bezpečnostní hranice.
Chcete embeddingy zapojit do skutečné AI aplikace?
V kurzu Programátor AI Agentů propojujeme jazykové modely s dokumenty, nástroji a aplikační logikou. Naučíte se navrhnout retrieval, RAG i agentní workflow tak, aby fungovaly nejen v ukázce, ale také v praxi.
Zdroje a další čtení
- Google Machine Learning Crash Course: Embeddings — úvod do hustých reprezentací a embeddingového prostoru
- Mikolov et al.: Efficient Estimation of Word Representations in Vector Space — původní práce k word2vec
- Reimers a Gurevych: Sentence-BERT — větné embeddingy pro efektivní sémantickou podobnost
- Malkov a Yashunin: HNSW — grafový index pro přibližné hledání nejbližších sousedů
- Model card: paraphrase-multilingual-MiniLM-L12-v2 — model použitý v ukázce
