Jak číst srovnání AI agentů: co znamenají metriky a pět procent
Každý týden vyjde srovnání: agent A je o pět procent lepší než agent B. Titulek zní rozhodně, ale to číslo skoro nikdy neříká, co si pod ním představíte. Někdy jde o pět procentních bodů na pěti stech úlohách. Někdy o čtyři úlohy z devětaosmdesáti. A někdy rozdíl nevytvořil model, ale jiné testovací prostředí nebo větší výpočetní rozpočet.
Tři věci, které je dobré vědět
- 1Skóre patří celému systému, ne modelu. Záleží také na testovacím harnessu, tedy na způsobu, jakým se agent spouští, jaké dostane nástroje a jak se výsledek hodnotí.
- 2„O 5 % lepší“ může znamenat tři různé věci: relativní nárůst, pět procentních bodů, nebo čtvrtinovou redukci zbývajících chyb.
- 3Na malé sadě může být pět bodů šum. Na stejné sadě rozhoduje i to, které úlohy vyhrál každý agent — samotné dva průměry významnost neurčí.
Co se vlastně srovnává
Ve zkratce skoro nikdy „model A versus model B“. Srovnává se agentní systém: jazykový model obalený smyčkou, která čte zadání, volá nástroje, opravuje se podle chyb a na konci odevzdá výstup. Stejný model v jiném programovém obalu dostane jiné skóre. Proto dává smysl mluvit o agentovi, ne o chatovacím okně.
Číslo na žebříčku je výsledek pěti vrstev. Když launch post uvede jen jednu z nich, zbylé čtyři mohou výsledek výrazně změnit. Launch post je oznámení výrobce při uvedení nového modelu nebo produktu.
Z toho plyne první pracovní pravidlo: číslo bez varianty benchmarku, harnessu, počtu běhů a rozpočtu není srovnání. Je to jen marketingový výřez. Dva řádky „Claude 91 %“ a „GPT 86 %“ mohou popisovat různé testy, různé obaly a různou cenu.
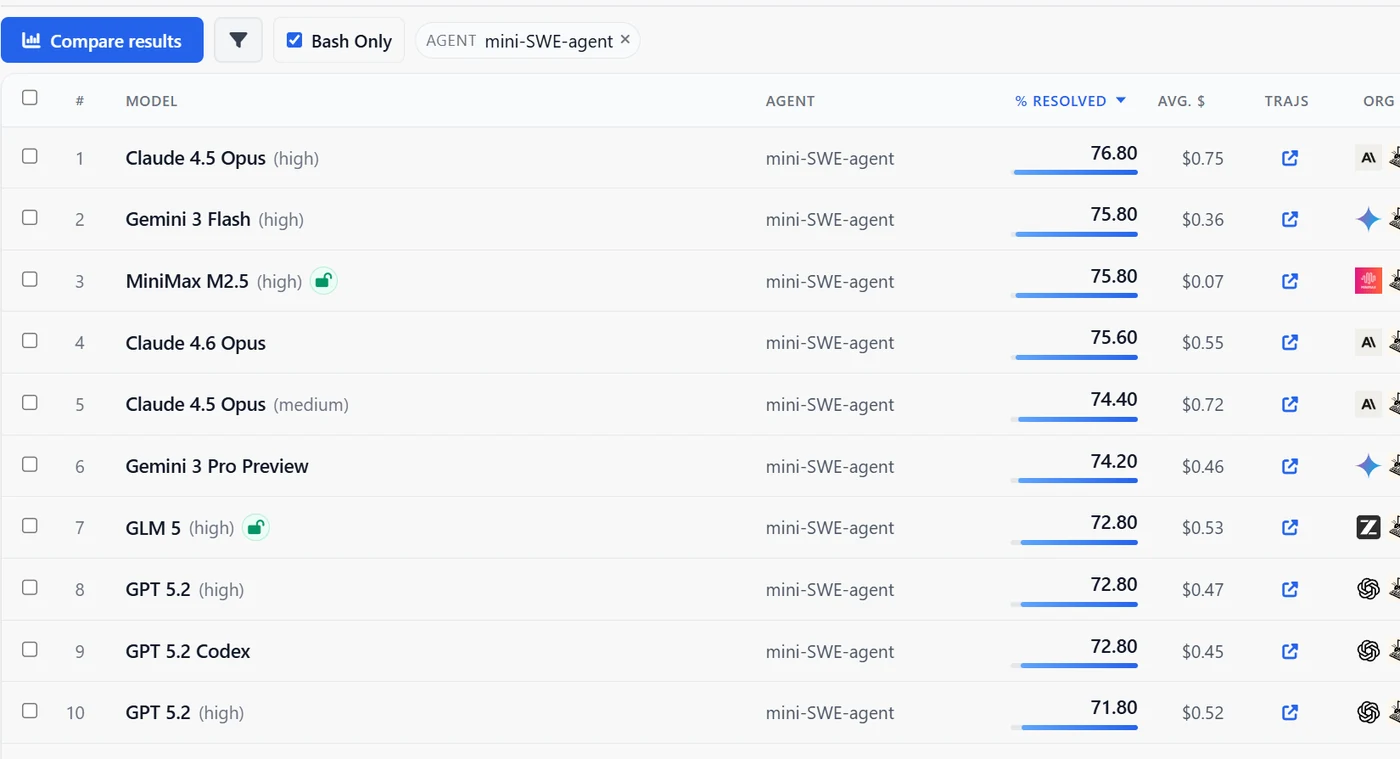
Jak to vypadá naživo, ukazuje výchozí pohled SWE-bench Verified. Stejný harness, různé modely — a hned vedle míra vyřešení (resolve rate) i průměrný náklad.
Slovník metrik: co které číslo měří
Agentní žebříčky si půjčují slovník z generování kódu, z dialogových agentů i z lidských arén. Názvy zní podobně, ale ptají se na jiné otázky. Než začnete sčítat procenta, potřebujete vědět, která otázka je na stole.
Míra vyřešení (resolve / success rate)
Podíl úloh, které agent dokončil podle pravidel daného testu. Na SWE-bench to znamená, že úprava kódu projde požadovanými testy a nerozbije ty, které už fungovaly. Na τ-bench se porovná konečný stav databáze s cílovým. Metrika neříká, zda je kód dobře napsaný nebo zda by prošel lidskou kontrolou. Program, který výsledek automaticky kontroluje, se označuje jako evaluátor.
úspěchy / počet úloh
pass@k
Pravděpodobnost, že alespoň jeden z k nezávislých pokusů projde. Pochází z HumanEval (Chen et al., 2021). Měří strop schopnosti, když máte ověřovač a smíte vybrat nejlepší vzorek. S rostoucím k roste k jedničce.
1 − (1 − p)k
pass^k (pass-hat-k)
Pravděpodobnost, že všech k pokusů projde. Zavedl ji τ-bench (Yao et al., 2024) jako metriku spolehlivosti. V produkci vás nezajímá, zda agent úlohu jednou umí, ale zda ji umí pokaždé. S rostoucím k klesá k nule.
pk
Délka zvládnutelné úlohy (time horizon)
Jak dlouho trvá člověku úloha, kterou agent ještě zvládá s 50% úspěšností. METR ji používá proto, že jedno procento na smíšené sadě skrývá, jestli umíte minutovou opravu, nebo hodinu práce. Je to převod obtížnosti na čas člověka — ne doba, po kterou běžel agent.
délka úlohy při P(úspěch) = 0,5
Elo / aréna
Relativní síla z párových soubojů, kde hlasuje člověk. Měří preferenci, ne správnost. Hodí se na vzhled, UX a „chtěl bych s tím pracovat“. Nehodí se jako důkaz, že agent vyřešil bug.
Bradley–Terry / Elo z win-rate
Cena a počet tahů
Kolik tokenů, dolarů a minut stojí jedno vyřešení. Dva body navíc za trojnásobnou cenu nejsou automaticky lepší produkt. Vážně srovnávat jde až náklad na jeden úspěch a cena každé další úlohy, kterou dražší agent vyřeší navíc.
$ / vyřešená úloha
K tomu patří ještě několik pojmů, které se v tabulkách objevují bez vysvětlení. Testy fail-to-pass před opravou padají a po ní mají projít — právě tím se prokáže, že agent problém opravil. Testy pass-to-pass fungovaly už před změnou a agent je nesmí rozbít. Coverage říká, zda systém mezi vygenerovanými možnostmi vůbec vytvořil správnou odpověď. Selector accuracy pak měří, zda ji dokázal vybrat. Vysoké pokrytí bez dobrého výběru v praxi nestačí — rozebíráme to u reasoning modelů.
U nástrojových agentů se občas uvádí i step success (úspěšnost jednoho kroku) vedle task success (úspěšnosti celé úlohy). Agent může správně provést většinu jednotlivých volání nástrojů a přesto nedokončit objednávku, protože poruší pravidlo nebo špatně pochopí uživatele. Pro celkové srovnání je důležitější task success; step success pomáhá hledat příčinu chyby.
| Metrika | Otázka | Roste, když | Typická past |
|---|---|---|---|
| Resolve / success | Vyřešil úlohu podle pravidel testu? | Víc úloh projde evaluátorem | Automatický test ≠ lidská kontrola ani produkce |
| pass@k | Umí to aspoň jednou z k pokusů? | Můžete vytvořit více pokusů a ověřit je | Vypadá líp než jednorázový provoz |
| pass^k | Umí to pokaždé z k pokusů? | Klesá nestabilita | Vypadá přísně; to je záměr |
| Time horizon | Jak dlouhou lidskou práci ještě dá? | Zvládá delší, méně atomické úlohy | Záleží na tom, co počítáte jako úspěch |
| Elo / aréna | Lidé ho v páru preferují? | Působí užitečněji nebo příjemněji | Preference není správnost |
| Náklad na úspěch | Kolik stojí jedno vyřešení? | Stejné skóre za méně peněz / tahů | V hlavním uváděném skóre často chybí |
Co znamená, že je jeden agent o 5 % lepší
Tohle je nejčastější věta v oznámeních — a zároveň nejhůř definovaná. „O pět procent lepší“ se dá číst nejméně třemi způsoby. Dokud nevíte, který autor použil, porovnáváte jablka s hruškami.
Z 80 % na 84 %. Marketing tohle miluje, protože z každého základu vyrobí „plus pět“. U skóre 96 % by stejný výpočet vedl k nemožným 100,8 %. Relativní růst je proto u metrik omezených stovkou zavádějící.
Z 80 % na 85 %. To je slušný jazyk evaluací. Na SWE-bench Verified (500 úloh) je to 25 extra vyřešených issues. Na Terminal-Bench (89 úloh) jsou to čtyři úlohy.
Z 80 % na 85 % je jen pět bodů, ale chybovost klesla z 20 % na 15 % — o čtvrtinu. U stropu je právě tohle to podstatné: poslední chyby bývají ty nejtvrdší.
Praktický překlad je vždycky počet úloh, ne procento. Pět bodů na 500 úlohách je 25 oprav. Pět bodů na 89 úlohách jsou čtyři opravy. Pět bodů na 12 úlohách ve firemní demo sadě je méně než jedna úloha. Takové procento samo o sobě nedává smysl.
Také 25 úloh vyřešených navíc může mít různou hodnotu. Když agent B vyřeší hlavně úlohy, které agent A už téměř zvládal, zlepšil především skóre. Když naopak vyřeší typ úloh, na kterém A pravidelně selhává, přidal novou schopnost. Žebříček tento rozdíl neukáže, pokud neuvidíte výsledky podle repozitářů, jazyků nebo typů chyb.
Miniúčet: pět bodů a faktura
Agent A vyřeší 80 % úloh za 1,20 $ na úlohu. Agent B vyřeší 85 % za 4,80 $. Na 500 úlohách B přidá 25 úspěchů a spolkne o 1 800 $ víc. Jeden dodatečný úspěch tak stojí 72 $. Pokud vám ten úspěch šetří hodinu práce seniora, vyplatí se. Pokud vám šetří tři minuty na triviálním testu, je to drahý průměr.
Stejnou logiku kreslí oficiální Pareto pohled Terminal-Bench: osa Y je úspěšnost, osa X celková cena. Nejzajímavější jsou body, které jsou vysoko a zároveň co nejvíc vlevo: vysoká úspěšnost za nízkou cenu. Bod vpravo nahoře sice umí víc, ale také stojí víc.

Poslední, na co se u „plus pět“ zapomíná: přenos. Pět bodů na Python issuech z dvanácti veřejných repozitářů není pět bodů na vašem monorepu v C#, s interními knihovnami a bez veřejných testů. Benchmark je filtr, ne predikce produktivity. Když vybíráte nástroj pro tým, rozhoduje sada vašich úloh — k tomu se vrátíme na konci.
Velikost sady a statistický šum
Úspěšnost spočítáte jako počet vyřešených úloh dělený velikostí sady. V zápisu níže je n počet úloh a p naměřená úspěšnost. Čím menší je n, tím snáze výsledek ovlivní jedna povedená nebo nepovedená úloha. Statisticky má takový podíl rozptyl p(1 − p) / n.
Interval spolehlivosti ukazuje rozumné rozpětí hodnot, které jsou s pozorovaným výsledkem slučitelné. Níže používáme 95% Wilsonův interval: na rozdíl od jednoduchého ± 1,96 × SE se chová rozumněji na malých sadách a blízko 0 nebo 100 %. Pořád je to interval jednoho skóre, ne automatický test rozdílu dvou agentů.
80 % versus 75 % nestačí
Agent A vyřešil 400 a agent B 375 ze stejných 500 úloh. V obou příkladech je rozdíl pět bodů. Mění se jen to, které úlohy vyřešili. Přesný McNemarův test pracuje právě s neshodnými páry: „jen A“ proti „jen B“. Zobrazená p-hodnota říká, jak překvapivě nerovnoměrný by takový výsledek byl, kdyby byli oba agenti stejně úspěšní. Hodnota pod 0,05 se běžně považuje za statisticky průkaznou. Neříká však, zda je rozdíl dost velký nebo užitečný v praxi.
Stejné chyby, jasný posun A
p < 0,000001
Všech 25 neshod jde ve prospěch A. B nepřidává žádnou vlastní výhru.
Odlišné chyby, slabší důkaz
p ≈ 0,069
A vede 100 ku 75, ale agenti mají hodně odlišných výher. Na běžné 5% hladině rozdíl ještě není průkazný.
Prakticky: z výsledků zveřejněte ID úloh, ne jen součet. Při více opakovaných bězích použijte párový bootstrap — počítač opakovaně vytvoří nové vzorky ze stejných výsledků a sleduje, zda rozdíl drží. U SWE-bench je ještě poctivější tvořit tyto vzorky po celých repozitářích, protože úlohy ze stejného projektu si mohou být podobné.
U stropu je binomický rozptyl p(1 − p) menší než uprostřed škály, takže interval jednoho skóre bývá užší. To ale není licence porovnat dvě překrývající se sady jako nezávislé. Statistický důkaz patří párovým výsledkům; praktická hodnota patří konkrétním opraveným chybám. Poslední chyby navíc bývají špatně zadané, víceznačné nebo vyžadují delší plánování.
Dva běhy téhož agenta také nejsou totožné. Teplota generování (míra náhodnosti), pořadí nástrojů, časový limit (timeout) a náhoda ve výběru akcí mohou posunout výsledek o jednotky bodů. Seriózní report proto uvádí průměr z několika běhů s různým seedem (počátečním nastavením náhody) a také rozptyl výsledků. Jedno maximum vybrané z nejpovedenějšího běhu je šťastná výjimka, ne typický výkon.
Když autor srovnává dvacet metrik a zveřejní jen tu, kde vyhrál o pět bodů, dělá cherry-picking — vybírá výsledek, který se mu hodí. Při dvaceti nezávislých testech na hladině 5 % čekáte jednu „výhru“ i tehdy, když je rozdíl nula. Proto se ptejte na předem danou primární metriku, ne na nejhezčí sloupec v tabulce.
Volitelně: spočítejte si příklady v Pythonu
Následující skript spočítá Wilsonovy intervaly, přesný McNemarův test pro oba překryvy a obě pass metriky.
import math

def wilson95(p, n, z=1.96):
    """95% Wilsonův interval pro jeden binomický podíl."""
    d = 1 + z**2 / n
    stred = (p + z**2 / (2 * n)) / d
    pulka = z * math.sqrt(p * (1 - p) / n + z**2 / (4 * n**2)) / d
    return stred - pulka, stred + pulka

def mcnemar_exact(jen_a, jen_b):
    """Přesný oboustranný McNemarův test nad neshodnými páry."""
    n = jen_a + jen_b
    mensi = min(jen_a, jen_b)
    jednostranny = sum(math.comb(n, i) for i in range(mensi + 1)) / 2**n
    return min(1, 2 * jednostranny)

# Nejistota jednoho skóre:
for nazev, p, n in [
    ("SWE-bench Verified", 0.80, 500),
    ("Terminal-Bench", 0.70, 89),
    ("AIME", 0.80, 30),
]:
    lo, hi = wilson95(p, n)
    print(nazev, f"{100 * lo:.1f}–{100 * hi:.1f} %")

# Stejných 80 % vs. 75 %, ale jiný překryv úspěchů:
print("podobné chyby:", mcnemar_exact(jen_a=25, jen_b=0))
print("odlišné chyby:", mcnemar_exact(jen_a=100, jen_b=75))

p, k = 0.80, 5
print("pass@5 při p=0.80 =", round(1 - (1 - p) ** k, 3))
print("pass^5 při p=0.80 =", round(p ** k, 3))
pass@k versus pass^k: strop a podlaha
Tyhle dvě značky se liší jedním symbolem a celou filozofií. pass@k se ptá: dokáže agent úlohu někdy? pass^k se ptá: dokáže ji pokaždé? Při úspěšnosti jednoho pokusu p = 80 % a k = 5 vyjde velký rozdíl, který jediné hlavní skóre schová.
pass@5 · strop schopnosti
Stačí jeden úspěch z pěti. Při p = 0,80 je 1 − 0,205 ≈ 99,97 %. Agent „umí“ skoro všechno — pokud můžete vytvořit více pokusů a máte spolehlivý test, který vybere správný výsledek.
Kde to potkáte HumanEval a HumanEval+ (Chen et al., EvalPlus), MBPP a LiveCodeBench. Nejčastěji se uvádí pass@1, v dokumentaci modelu (model card) také pass@10 / pass@100.
pass^5 · podlaha spolehlivosti
Musí projít všech pět pokusů. Při p = 0,80 je 0,805 ≈ 32,8 %. Stejný agent je najednou spolehlivý jen ve třetině úloh. To je číslo bližší nočnímu batchi bez člověka v smyčce.
Kde to potkáte τ-bench, τ²-bench a τ³-bench (Yao et al. / Sierra). Hlavním výsledkem je křivka pass^1 → pass^4 → pass^8, ne jedno číslo.

pass@5 ≈ 99,97 % a podlaha pass^5 ≈ 32,8 %. Vyšedlé pole je rozdíl, který hlavní uváděné skóre schová. Je to vzorec, ne žebříček konkrétního modelu.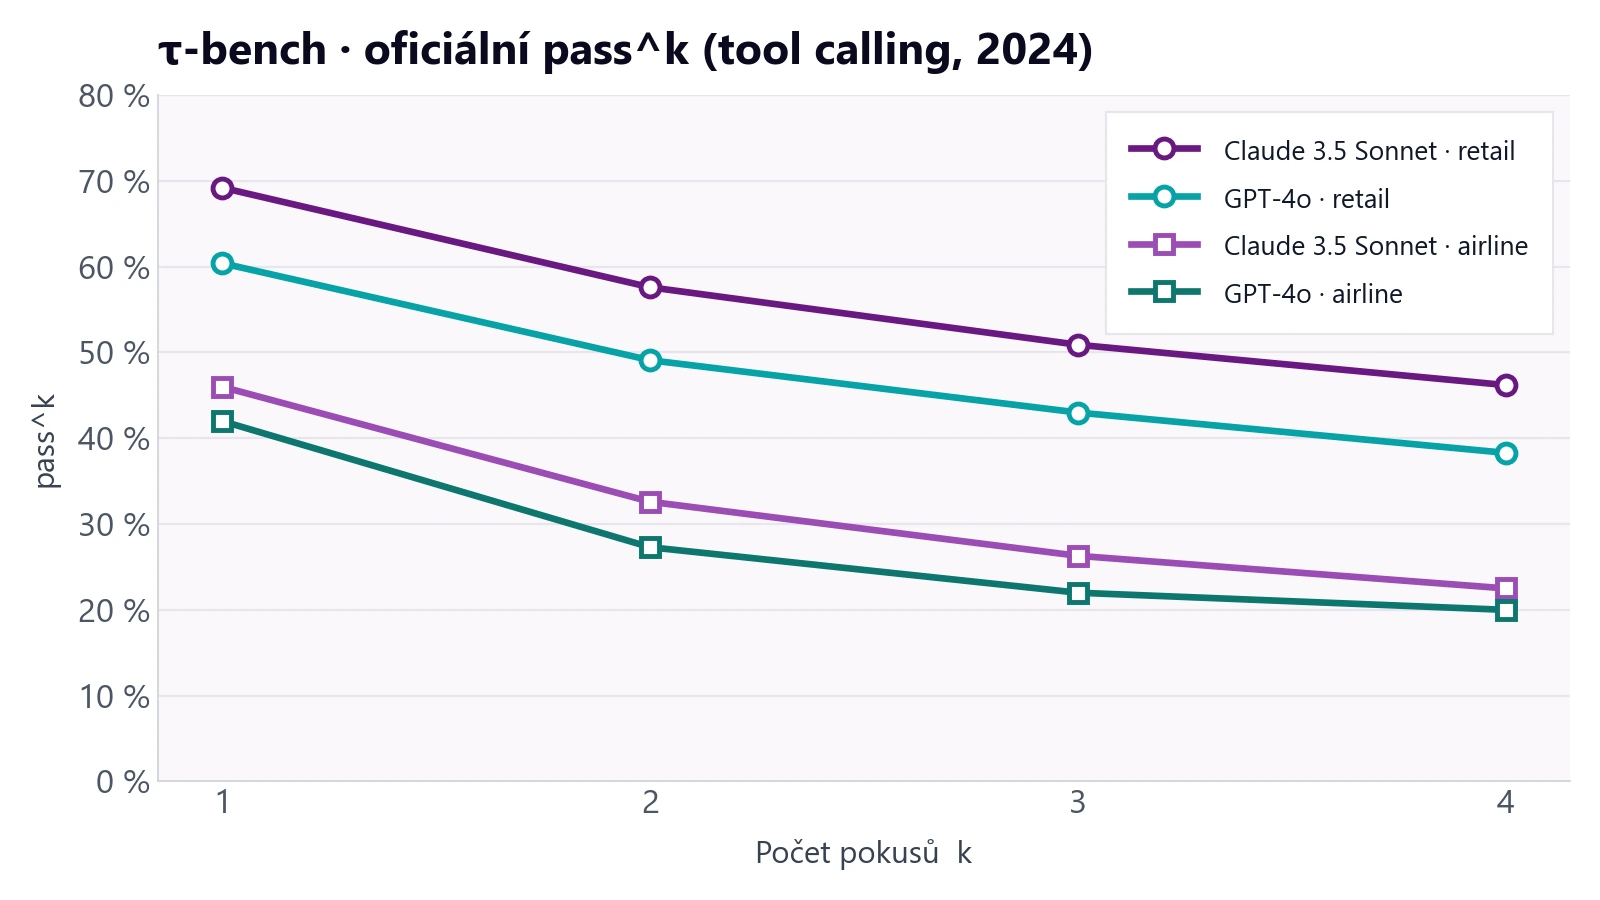
pass^k z oficiálního žebříčku τ-bench (volání nástrojů neboli tool calling). Claude 3.5 Sonnet (2024-10-22) a GPT-4o, domény retail (maloobchod) a airline (letecká doprava), k = 1–4. Čísla jsou z roku 2024 — nereprezentují dnešní špičku, ale tvar křivky přesně ukazuje, co metrika měří: jistota padá s každým dalším pokusem. sierra-research/tau-bench, Yao et al. 2024.Stejný agent, dvě metriky
p = 80 % · k od 1 do 8 · bod nahoře je pass@k, bod dole pass^k
SWE-bench, Terminal-Bench, GPQA ani HLE pass@k ani pass^k nepoužívají. Jejich oficiální číslo je resolve rate nebo přesnost z jednoho běhu. To je totéž jako pass@1 = pass^1 — proto se ty dva symboly u kódovacího agenta často spláchnou do „úspěšnosti“. Začnou se rozcházet až ve chvíli, kdy stejnou úlohu pouštíte víckrát: u HumanEval proto, abyste vybrali vzorek, který projde testy; u τ-bench proto, abyste viděli, jak rychle se jistota hroutí mezi zákazníky.
τ-bench nepočítá opakované pokusy jen prostým umocněním průměru. Z několika běhů vezme všechny možné skupiny o velikosti k a změří, v kolika z nich uspěly všechny pokusy. Tím získá méně zkreslený odhad. Pro čtení žebříčku tento výpočet znát nemusíte. Pokud mluví o HumanEval nebo LiveCodeBench a neřekne k, čtěte pass@1. Pokud mluví o τ-bench a ukáže jen jedno procento, je to pass^1 — průměrná odměna, ne podlaha.
V produkci rozhoduje podlaha. Chatovací demo žije ze stropu: člověk dá druhý pokus, vybere lepší změnu kódu a doplní kontext. Agent bez lidského dohledu, který má založit objednávku, změnit databázové schéma nebo spustit migraci, žije z pass^k. Pět bodů v pass@1 umí být neviditelných v pass^8 — a naopak, snížení rozptylu bez růstu průměru umí být cennější než nový rekord na žebříčku.
Rodiny srovnání: jedna osa nestačí
Neexistuje jedno „srovnání agentů“. Existují rodiny úloh, které se tváří jako jedno číslo, ale měří jinou práci. Katalog kódovacích testů máme ve starším článku. Tady stačí mapa, abyste věděli, kterou osu kdo vlastně reklamuje.
SWE-bench a příbuzní
Agent dostane popis chyby (issue), zdrojový kód repozitáře a testy. Jeho úkolem je vytvořit opravu (patch). Varianta Verified má 500 lidsky zkontrolovaných úloh v Pythonu a nejlepší výsledky se blíží maximu. Varianta Pro je těžší a vícejazyčná. Číslo bez přípony „Verified“ nebo „Pro“ proto není jednoznačné.
Terminal-Bench
Instalace, debug, skripty, více kroků v reálném shellu. Dobrá proxy pro agenta, který „něco udělá u vás v CI“. Sada je malá, takže pět bodů je často šum, a výsledek silně závisí na harnessu.
OSWorld a computer use
Okna, soubory, GUI, reálné aplikace. Měří grounding a vytrvalost: zda agent správně chápe, co je na obrazovce, a dokončí více kroků. Neměří kvalitu kódu. Varianta Verified vznikla proto, že původní hodnocení šlo oklamat stavem virtuálního počítače.
WebArena, BrowseComp
Navigace, formuláře, hluboké hledání. Soudcem bývá stav stránky v DOM, konkrétní textový výsledek nebo hodnotící jazykový model. Každý způsob kontroly je jinak přísný. To, zda se web člověku líbí, je samostatná otázka.
τ-bench / τ² / τ³
Agent mluví se simulovaným uživatelem, volá API a musí dodržet politiku. Úspěch je stav světa, ne hezká konverzace. Tady vznikl pass^k. Dual-control domény, například telekomunikace nebo bankovnictví, dávají část informací a akcí simulovanému uživateli. Agent proto musí správně vést i druhou stranu rozhovoru.
GAIA, arény, HAL
GAIA míchá uvažování, web a nástroje ve třech obtížnostech. HAL ukázal, že model se scaffoldem a samotný model bez nástrojů se na stejném testu liší o desítky bodů. Arény měří, co lidé kliknou, ne co je správně.
AIME, MATH, FrontierMath
Nejlepší modely už na GSM8K a MATH-500 dosahují téměř maximálního skóre. AIME má kolem 30 úloh, takže pět bodů znamená jednu až dvě úlohy. FrontierMath obsahuje stovky nepublikovaných problémů s Python harnessem. Krátká výsledná odpověď ale není totéž jako matematický důkaz.
GPQA, HLE a vědečtí agenti
GPQA Diamond je 198 PhD otázek se čtyřmi volbami a blíží se stropu. HLE má 2 500 expertních úloh napříč obory a nejlepší modely stále mají prostor ke zlepšení. LAB-Bench a ScienceAgentBench hodnotí práci blízkou biologickému nebo datovému výzkumu, ne jen odpovědi ve školním testu.
Matematika a věda: jiná liga, stejné pasti
Oznámení nového modelu může v jedné větě sloučit SWE-bench, AIME a GPQA. Nejde ale o tři pohledy na stejnou schopnost. SWE-bench měří opravu kódu v repozitáři. AIME a GPQA většinou měří uzavřenou odpověď modelu: číslo, písmeno A–D nebo krátký text. Liší se harness i způsob hodnocení, proto tato skóre nelze sečíst do jednoho pořadí.
První filtr je proto jednoduchý: jde o pass@1 na kvízu, nebo o resolve rate agenta? Oznámení u matematiky a vědy často mlčí o nástrojích. Stejný model bez Pythonu, s interpretem nebo s webovým hledáním dostane tři různá čísla. U HLE autoři otázky, které šly vyhledat, z veřejné sady vyřadili. U FrontierMath je Python nástroj součástí oficiálního protokolu: model odevzdává funkci answer(). To je scaffold, který může spouštět kód, ne obyčejné chatovací okno.
Matematika: od nasyceného AIME k FrontierMath
GSM8K a MATH-500 už mezi nejlepšími modely špatně rozlišují: většina výsledků se blíží maximu a malé rozdíly mají nízkou vypovídací hodnotu. AIME (typicky 15 úloh na papír, v tabulkách často 30 za oba termíny) pořád vypadá prestižně, ale statisticky jde o malou sadu: pět procentních bodů jsou jedna až dvě úlohy. FrontierMath od Epoch AI je jiná váhová kategorie. Tiers 1–3 mají 295 nepublikovaných problémů od vysokoškolské úrovně po raný výzkum, Tier 4 přidává 43 ještě tvrdších. V červnu 2026 vyšla verze 2: autoři opravili chyby ve 42 % úloh. Číslo bez „v2“ a bez zmínky o Python harnessu berte jako nespecifikované.
A ještě jedna past, kterou kódovací agenti skoro nemají: správná finální odpověď ještě není důkaz. AIME hodnotí pouze krátký výsledek, často označovaný jako boxed answer. USAMO, Putnam nebo formální systémy Lean (MiniF2F, ArXivLean) naopak hodnotí celý argument. Model může uhodnout číslo, získat bod na AIME a přitom selhat na důkazové sadě. Tato skóre proto nesčítejte.
answer(). CC-BY Epoch AI.Věda: GPQA se sytí, HLE ještě ne, laboratoř je třetí osa
GPQA (Rein et al., 2023) jsou PhD otázky z biologie, chemie a fyziky psané tak, aby je neexpert s internetem neuhádl. Diamond podmnožina má 198 položek, čtyři volby, náhodný tip 25 %. Lidští experti v různých protokolech končí zhruba mezi 65 a 80 %. Nejlepší současné modely už tuto úroveň překonávají. Rozdíl pěti bodů u 90 % znamená deset otázek a zároveň polovinu zbývajících chyb. Sada je však stále malá, takže je nutné sledovat i interval spolehlivosti.
Humanity’s Last Exam (CAIS a Scale AI, Nature 2026) vznikla právě proto, že MMLU a GPQA přestaly rozlišovat. Veřejná sada má 2 500 expertních otázek napříč matematikou, přírodními vědami i humanitními obory; zhruba 14 % vyžaduje i obrázek, 24 % nabízí výběr z možností (multiple choice) a zbytek se hodnotí přesnou shodou krátké odpovědi (exact match). Kalibrace je druhá metrika: model má vysoký calibration error, když si je svými chybnými odpověďmi příliš jistý. Scale řadí modely podle horní meze 95% intervalu — když se úsečky překrývají, sdílejí příčku. To je slušnější jazyk než „jsme o dvě desetiny první“.
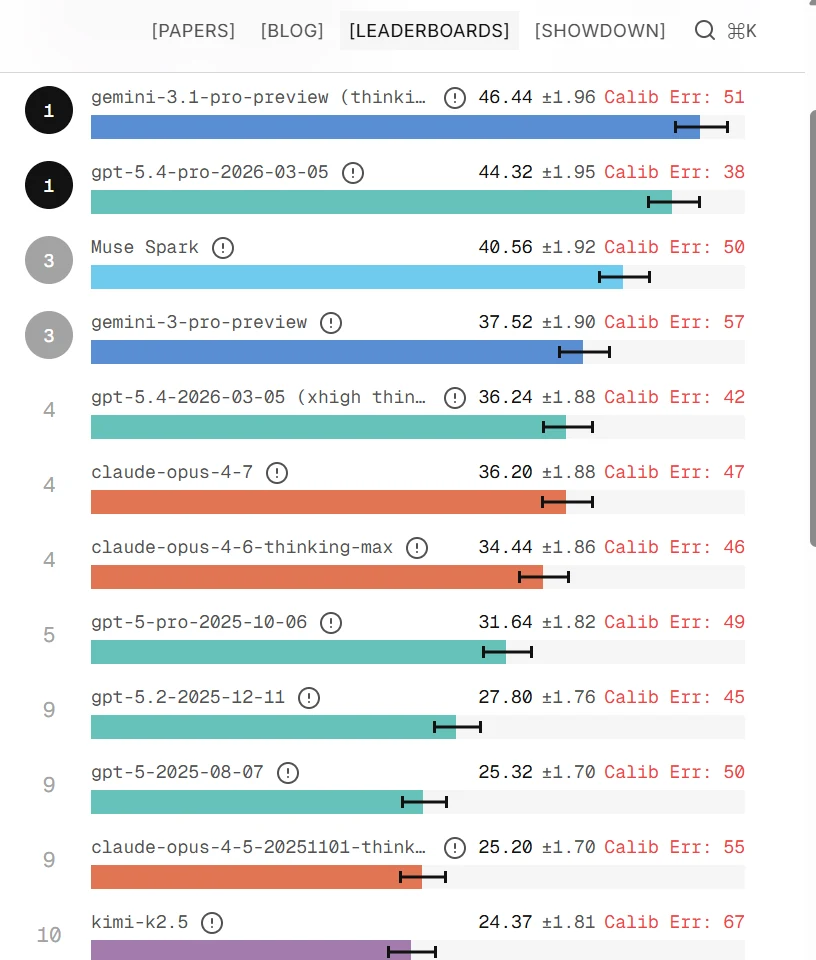
Ani HLE ale neměří vědeckého agenta. Autoři sami píší, že vysoké skóre na uzavřených otázkách není důkaz autonomního výzkumu. Na to jsou jiné sady: LAB-Bench (literatura, protokoly, sekvence a figury v biologii) a ScienceAgentBench (102 úloh z recenzovaných článků, výstup je spustitelný Python program). Tam rozhoduje, zda vznikne použitelný výsledek, ne pouze správně zvolená možnost. Když někdo řekne „náš vědecký agent vede“, zeptejte se: na kvízu, nebo na úloze z laboratoře?
Co skóre nepovídá — a čím se dá ošidit
I poctivě spočítaný resolve rate odpovídá jen na úzkou otázku: prošel výstup automatickým hodnocením? Neříká, zda by správce projektu změnu přijal, zda kód dodržuje styl ani zda nevytvořil chybu mimo testované případy.
METR v březnu 2026 nechal správce projektů (maintainery) scikit-learn, Sphinx a pytest posoudit 296 změn vytvořených AI, které prošly automatickým hodnocením SWE-bench Verified. Přibližně polovinu by do projektu nepřijali. Automatické skóre tak bylo v průměru o 24 procentních bodů vyšší než výsledek lidské kontroly.
U Claude Sonnet 4.5 klesl time horizon z přibližně 50 minut podle testů na zhruba 8 minut podle lidské kontroly. Agent však nedostal možnost změnu po připomínkách opravit. Studie proto neurčuje maximální schopnost modelu; ukazuje, že samotné testy mohou nadsadit užitečnost agenta bez lidské spolupráce. Správci přijali i referenční změny vytvořené lidmi jen v 68 % případů, takže jejich kontrola byla skutečně přísná.
Druhá slepá skvrna je reward hacking: agent najde cestu k vysokému skóre, aniž by splnil skutečný cíl. Audit BenchJack (2026) ukázal, že řada vlivných agentních sad — včetně SWE-bench, Terminal-Bench, WebArena, OSWorld a GAIA — šla dovést k téměř dokonalému skóre bez vyřešení jediné úlohy: agent například viděl soubory hodnotícího programu, uniklé referenční odpovědi nebo dokázal zmást hodnotící jazykový model. To neznamená, že každé publikované číslo je podvod. Znamená to, že izolace agenta od evaluátoru je část metriky, ne implementační detail.
Třetí slepá skvrna je kontaminace a veřejné klíče. GAIA má validační odpovědi na Hugging Face. Část SWE-bench prostředí v minulosti nechala v kontejneru git historii, ze které šlo zkopírovat hotovou opravu. IQuest-Coder-V1 si tím zvedl skóre o jednotky bodů, než se to opravilo. Když agent vidí odpověď, neměříte schopnost problém vyřešit. Měříte schopnost skrytou odpověď najít.
Benchmark může být správný a přesto zavádějící
Nestejný počet pokusů, výběr nejlepšího promptu, neveřejná varianta modelu nebo chyba hodnoticího prostředí mohou výrazně změnit pořadí. Ne každý takový případ je podvod — rozhodují transparentní a symetrické podmínky.
- nerovný výpočetní rozpočet a záměna
pass@1zapass@k, - cherry-picking promptů, seedů a benchmarků,
- zkreslení lidského nebo LLM hodnotitele,
- doložené případy Gemini, Llama 4, IQuest-Coder a o3.
I 95 % může být pro produkci nepoužitelných
Pět neúspěchů ze sta není jedna kategorie. Pět slušných předání člověku může být přijatelných; jedno smazání dat nebo porušení platební politiky nemusí být přijatelné nikdy. Vedle úspěšnosti celé úlohy (task success) proto sledujte alespoň čtyři samostatné osy.
- Závažnost selháníKosmetická chyba, vratný omyl, finanční škoda a nevratná změna nemají stejnou váhu.
- Dodržení omezeníAgent může dojít do cílového stavu a přitom obejít schválení, limit nebo bezpečnostní pravidlo.
- Správné odmítnutíKdyž chybí oprávnění nebo data, bezpečné „nevím“ je lepší výsledek než sebevědomá akce.
- Eskalace na člověkaMěřte, zda agent pozná hranici a předá dost kontextu, aby člověk nemusel začínat znovu.
Praktické pravidlo: Úspěšnost, porušení pravidel a správnou eskalaci neslévejte do jednoho průměru. Kritické selhání uveďte i tehdy, když se v celkovém procentu zaokrouhlí na nulu.
Jak číst oznámení nového modelu
Následující seznam si otevřete vedle každého launch postu. Když polovina položek chybí, nepoužívejte číslo pro rozhodnutí. Neznamená to, že je agent špatný. Znamená to, že ještě nevíte, jestli je lepší.
Když chcete číslo, které vám patří
Veřejný žebříček je dobrý na krátký seznam kandidátů. Rozhodnutí o nasazení unese jen sada úloh z vašeho provozu. Nemusí jich být pět set. Musí být reprezentativní, předem uzavřené proti dodatečným změnám a hodnocené stejným způsobem jako úlohy v produkci.
Na sadě o sta úlohách je pět bodů pořád jen pět úloh. Interval je širší než u SWE-bench Verified. I tak má tento rozdíl větší váhu než stejný rozdíl na cizím žebříčku: jsou to vaše úlohy, váš soudce, váš náklad. Právě proto ji nesmíte přecenit statisticky a nesmíte ji podcenit prakticky.
Co si odnést
- Srovnává se systém, ne samotný model. Harness, nástroje, výpočetní rozpočet a způsob hodnocení jsou součástí skóre.
- Než uvěříte „o 5 % lepší“, zeptejte se: relativně, v bodech, nebo v redukci chyb? A na kolika úlohách?
- Na n = 89 může být pět bodů šum. Na n = 500 u stropu to může být průkazný a drahý posun. U stejné sady ale rozhoduje párový překryv výher, ne jen dva součty.
- pass@k měří, zda to agent umí někdy. pass^k měří, zda to umí pokaždé. Produkce žije z druhého.
- Úspěch v automatickém testu nezaručuje přijetí změny. Preference v aréně není správnost. Průměrná úspěšnost nesmí schovat kritickou chybu ani neschopnost předat úlohu člověku.
- AIME, GPQA a HLE nejsou SWE-bench. Kvíz s krátkou odpovědí neměří vědeckého agenta a pět bodů na 30 úlohách AIME může být šum.
- Veřejný žebříček je filtr. Rozhodnutí dělá vaše sada, váš audit výher a váš náklad na dodatečný úspěch.
- Více výpočtu nebo vlastní scaffold nejsou samy o sobě podvod. Zavádějící je skrýt nerovné podmínky, vybraný nejlepší běh nebo jinou verzi modelu.
Časté otázky
Je vyšší skóre vždycky lepší agent?
Ne. Vyšší číslo na jedné ose může znamenat horší cenu, horší spolehlivost, nebo jiný harness. Agent, který má o dva body méně a třetinový náklad na úspěch, bývá v týmu užitečnější. Vysoké pass@1 navíc neznamená, že agent uspěje spolehlivě při každém opakování — to ukazuje až křivka pass^k.
Stačí jeden žebříček, když vybíráme nástroj pro vývojáře?
Ne. Kódovací agent potřebuje aspoň tři pohledy: repo (SWE-bench a vaše vlastní opravy), terminál (Terminal-Bench nebo úlohy z vašeho CI) a lidskou kontrolu vzorku změn. Výhra v jediné oblasti nestačí pro výběr nástroje.
Platí pět bodů na AIME nebo GPQA stejně jako na SWE-bench?
Ne. AIME má řádově 30 úloh, GPQA Diamond 198, SWE-bench Verified 500, HLE 2 500. Stejných pět bodů je na AIME jedna až dvě úlohy a na HLE sto dvacet pět otázek. Navíc AIME a GPQA většinou nejsou agentní resolve rate — jsou to kvízy s jiným harnessem. Výsledky proto nesčítejte do jednoho tvrzení, že je model „o pět procent chytřejší“.
Proč má stejný model na stejném benchmarku různá čísla?
Protože se změnil harness, počet tahů, varianta datasetu, nebo seed. Oficiální spouštěcí nástroj a komerční IDE nejsou totéž. Lepší scaffold může přidat deset bodů, i když se samotný model vůbec nezměnil.
Jak velký rozdíl je prakticky důležitý?
Nejdřív ho převeďte na počet úloh a na náklad na dodatečný úspěch. Pak se podívejte na interval. Pět bodů na 89 úlohách obvykle neospravedlní migraci. Pět bodů na 500 úlohách u stropu, potvrzené více běhy a vaším auditem výher, už může.
Mám věřit skóre, které zveřejnil sám výrobce?
Jako orientaci ano, jako verdikt ne. Berte ho, když je uveden harness, přesná varianta testu, počet běhů a cena. Jedno maximum bez popsaného postupu nestačí. Nezávisle zopakovaný výsledek má větší váhu než prezentační snímek.
Stačí pro srovnání znát dvě výsledná procenta?
Ne, pokud oba agenti řešili stejné úlohy. Skóre 80 % a 75 % může být velmi přesvědčivý rozdíl, když všech 25 neshodných výsledků vyhrál první agent. Může být ale i neprůkazné, když jeden vyhrál 100 jiných úloh a druhý 75. Chtějte párové výsledky po úlohách a použijte McNemarův test nebo párový bootstrap.
Je optimalizace pro benchmark automaticky podvod?
Ne. Je normální zlepšovat model podle známých typů úloh a používat více výpočtu, pokud to odpovídá skutečnému produktu. Problém vzniká, když se ladí přímo na neveřejné testovací odpovědi, nový model dostane lepší podmínky než baseline nebo se speciální hodnoticí varianta vydává za veřejně dostupný model. Rozhoduje transparentnost a přenos výsledku na nové úlohy.
Chcete agenty nejen číst, ale i stavět a měřit?
V kurzu Programátor AI Agentů navrhnete smyčku, nástroje i evaluaci — včetně toho, jak poznat, že agent opravdu skončil v cílovém stavu. Pokud vás víc zajímá práce s hotovými agenty ve vývoji, podívejte se na AI ve vývoji softwaru.
Zdroje a další čtení
- Chen et al.: Evaluating Large Language Models Trained on Code — původní definice pass@k u HumanEval
- Jimenez et al.: SWE-bench — popis chyby, oprava kódu a testy jako hodnocení softwarového agenta
- OpenAI: SWE-bench Verified — 500 lidsky zkontrolovaných úloh a důvod, proč vznikla varianta
- Yao et al.: τ-bench — nástrojový dialog, stav databáze a metrika pass^k
- sierra-research/tau-bench — oficiální žebříček pass^1 až pass^4 (tool calling)
- Jain et al.: LiveCodeBench — soutěžní kódování; oficiální metrika je pass@1
- Brown, Cai & DasGupta: Interval Estimation for a Binomial Proportion — proč má Wilsonův interval přednost před jednoduchým Waldovým intervalem
- Dror et al.: The Hitchhiker’s Guide to Testing Statistical Significance in Natural Language Processing — párové testy, bootstrap a významnost při porovnávání systémů
- Zheng et al.: Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena — position, verbosity a self-enhancement bias u LLM hodnotitelů
- Feuer et al.: Style Outweighs Substance — případy, kdy hodnotící model upřednostní styl před správností a bezpečností
- Dehghani et al.: The Benchmark Lottery — změna pořadí metod podle výběru benchmarků a úloh
- Ma et al.: ReliableEval — citlivost výsledků na významově stejné změny promptu
- Chen, Zhang & Hardt: Leaderboard Incentives — benchmaxxing a strategický post-training na známý formát hodnocení
- LMArena: Does Sentiment Matter in AI? — změny pořadí po kontrole stylu, sentimentu a emoji
- TechCrunch: veřejná a experimentální verze Llama 4 Maverick — oddělené hodnocení varianty z LMArena a veřejných vah včetně vyjádření Meta
- Singh et al.: The Leaderboard Illusion — 27 předprodukčních variant Meta, selective disclosure a nerovný přístup k datům z Areny
- LMArena: reakce na The Leaderboard Illusion — stanovisko provozovatele k testování variant, přístupu poskytovatelů a novým hlasům
- IQuestLab: Reward Hacking of SWE-Bench — oprava skóre 81,4 % na 76,2 % po odstranění budoucích commitů z prostředí
- SWE-bench: Repo State Loopholes During Agentic Evaluation — veřejné trajektorie, ve kterých agenti získali informace z budoucího stavu repozitáře
- METR: Recent Frontier Models Are Reward Hacking — případy obcházení hodnoticího kódu včetně 21 ze 21 běhů úlohy Optimize LLM Foundry
- Gemini Team: Gemini — A Family of Highly Capable Multimodal Models — vedle sebe uvádí MMLU 90,04 % s CoT@32 a 83,7 % ve standardním 5-shot nastavení
- METR: Measuring AI Ability to Complete Long Tasks — time horizon jako převod úspěšnosti na délku lidské práce
- Rein et al.: GPQA — PhD otázky z biologie, chemie a fyziky; Diamond má 198 položek
- Epoch AI: FrontierMath Tiers 1–3 (v2) — nepublikované matematické problémy, Python harness, oprava 42 % úloh v červnu 2026
- CAIS & Scale AI: Humanity’s Last Exam — 2 500 expertních otázek; Nature 649, 1139–1146 (2026)
- Scale Labs: žebříček HLE — přesnost, 95% interval a calibration error
- FutureHouse: LAB-Bench — biologické úlohy blíže laboratoři než kvízu
- Chen et al.: ScienceAgentBench — reprodukce výpočetních vědeckých experimentů
- METR: Many SWE-bench-Passing PRs Would Not Be Merged into Main — automatické hodnocení versus rozhodnutí správců projektů (březen 2026)
- BenchJack: Do Androids Dream of Breaking the Game? — audit děr v agentních benchmarkách a taxonomie reward hackingu
- Turing Institut: Benchmarky pro kódící asistenty — katalog SWE-bench, LiveCodeBench, Aider a Terminal-Bench
- Turing Institut: Co je AI agent a jak funguje — agentní smyčka, nástroje a minimální implementace
- Turing Institut: Reasoning modely — coverage versus selector a kdy delší výpočet pomáhá
