Když AI vyhraje benchmark: pokrok, nebo marketingový trik?
Benchmark je sada úloh a pravidel, která převádí výkon modelu na skóre. Model A získal 90 %, model B jen 86 %. První tedy vypadá jasně lepší. Co když ale první model dostal 32 pokusů, druhý jeden, první běžel s vyhledáváním a druhý bez něj? Čísla mohou být správná a srovnání přesto zavádějící. Tento článek ukazuje, jak takové rozdíly vznikají, jaké případy jsou skutečně zdokumentované a co zkontrolovat dřív, než podle žebříčku vyberete model pro vlastní projekt.
Tři pravidla pro rychlou kontrolu benchmarku
- 1Nesrovnávejte jen názvy. Porovnávejte celý systém: model, zadání (prompt), nástroje, počet pokusů, čas a hodnotitele.
- 2Nejlepší běh není typický běh. Ptejte se, kolik variant zadání a náhodných nastavení (seedů) předcházelo zveřejněnému výsledku.
- 3Hledejte primární data. Záznamy kroků agenta (trajektorie), hodnoticí kód a nezávislé zopakování testu mají větší váhu než graf v oznámení modelu.
Číslo není vlastnost modelu
Údaj „GPT-4 dosáhl v benchmarku 87 %“ působí jako pevná technická vlastnost modelu. Ve skutečnosti ale výsledek jazykového modelu není stálý parametr. Závisí na přesné verzi modelu, zadání pro model (promptu), náhodnosti generování, nástrojích, prostředí a způsobu hodnocení.
Změna jediné vrstvy může posunout skóre bez změny vah modelu. U kódícího agenta například testujete nejen schopnost napsat opravu, ale také kvalitu popisu úlohy, dostupné příkazy, stav repozitáře, časový limit a testovací harness — program, který celý pokus spouští a vyhodnocuje.
Jak poznat přesvědčivý důkaz?
Než rozebereme konkrétní způsoby zkreslení, potřebujeme vědět, čemu lze věřit. Ne každé obvinění z manipulace má stejnou váhu. Rozhoduje původ a úplnost dat, možnost test zopakovat, nezávislost zdroje i to, zda text prošel odbornou recenzí. Nejpřesvědčivější je kombinace veřejných dat a kódu s nezávislým zopakováním výsledku. Příspěvek na sociální síti se screenshotem takovou kontrolu nenahrazuje.
Více pokusů může legitimně zvýšit pass@k
Nejjednodušší způsob, jak zvýšit benchmarkové skóre, je nechat model odpovědět vícekrát. Metrika pass@k počítá úlohu jako vyřešenou, pokud uspěje alespoň jeden z k pokusů. Pro nezávislé pokusy s úspěšností p platí:
Pro jednu konkrétní úlohu, u níž každý nezávislý pokus uspěje se stejnou pravděpodobností 40 %, je pravděpodobnost alespoň jednoho úspěchu z deseti pokusů 99,4 %. Z průměrného benchmarkového pass@1 = 40 % však nelze pass@10 takto dopočítat, protože úlohy mají různou obtížnost. HumanEval proto pass@k odhaduje ze skutečně vygenerovaných řešení pomocí kombinatorického výpočtu, který omezuje zkreslení. Princip zůstává stejný: více pokusů dává více šancí na úspěch.
Alespoň jeden správný pokus
Dává smysl, pokud systém umí správné řešení automaticky rozeznat pomocí testů nebo jiného ověřovače. Bez spolehlivého výběru ale uživatel dostane deset odpovědí a neví, které věřit.
Kontrola: stejné k, stejné testy a cena všech pokusů.
Vyhraje nejčastější odpověď
Model vytvoří několik řešení a systém vybere většinu. To není totéž jako pass@k: správná odpověď může mezi návrhy být a přesto v hlasování prohrát.
Kontrola: počet vzorků, pravidlo výběru a dodatečné výpočetní náklady.
Z mnoha nastavení se zveřejní jen nejlepší
Výzkumník vyzkouší mnoho zadání, náhodných nastavení nebo verzí modelu a ukáže nejvyšší skóre. Číslo může být pravdivé, ale očekávaný výsledek náhodně zvolené konfigurace bude nižší.
Kontrola: kolik variant se testovalo a zda byl protokol určen předem.
Jeden model dostane více času a nástrojů
Agent s terminálem, vyhledáváním a 200 000 tokeny může porazit holý model s jednou odpovědí. To dokazuje kvalitu celého systému, ne automaticky lepší základní model.
Kontrola: tokeny, čas, hardware, počet opakování a cena na jednu úlohu.
Více výpočtu není podvod. Problém vzniká tehdy, když titulek porovnává nejlepší výsledek dražšího protokolu se standardním během konkurenta a rozdíl schová do poznámky pod čarou. Praktické srovnání proto musí vedle úspěšnosti uvádět také cenu, dobu čekání na výsledek (latenci) a počet volání modelu.
Jak se vybírá vítězná konfigurace
Počet pokusů není jediná proměnná. Výsledek mohou změnit i zdánlivé detaily: pořadí možností A–D, mezery v šabloně, formát odpovědi nebo příklady vložené do zadání. Studie When Benchmarks Are Targets ukázala, že drobné změny MMLU — testu znalostí z desítek školních a odborných oblastí — posouvaly modely až o osm příček. V jednom experimentu se po změně pořadí možností změnilo pořadí pěti z jedenácti modelů.
Výběr nejlepšího běhu (cherry-picking)
Seed je číslo, které inicializuje náhodnost generování. Když spustíte jedno zadání s dvaceti seedy a zveřejníte nejlepší běh, používáte stejný princip jako výběr nejlepšího z dvaceti (best-of-20). Totéž platí pro zadání: po výsledku lze snadno vybrat právě tu formulaci, která vašemu modelu sedí.
Férový postup odděluje vývojovou a testovací sadu. Na vývojové části zadání ladíte, před spuštěním testu ho uzamknete a na testovací sadě provedete předem určený počet běhů. Pokud se po každém výsledku vracíte k zadání, testovací sada se postupně mění ve vývojovou.
Výhodný test a cílené ladění na žebříček
Existují stovky benchmarků a jejich variant. Když firma ukáže pouze pět sad, na kterých vyhrála, čtenář nevidí dalších patnáct, kde byla průměrná. Tomuto problému se říká výběr výhodného benchmarku (benchmark lottery). Stejnojmenná studie ukazuje, že pořadí metod se může významně měnit podle výběru testovacích sad a metrik.
Cílené ladění na žebříček (benchmaxxing) jde dál: model, zadání nebo řídicí vrstva agenta se dlouhodobě přizpůsobuje známému formátu žebříčku. Nemusí znát konkrétní odpovědi. Stačí optimalizovat přesně to, co benchmark odměňuje. Takový výkon může být skutečný, ale nemusí se přenést na jinou testovací sadu, knihovnu nebo váš firemní repozitář.
Kdo hodnotí odpověď modelu?
Odpověď může hodnotit programový test, člověk nebo další jazykový model. Každá možnost měří něco jiného. Automatický jednotkový test (unit test) pozná, zda funkce vrací očekávaný výsledek, ale nemusí zachytit nečitelný kód, bezpečnostní problém nebo zbytečně složitou změnu. Člověk vidí užitečnost, ale může preferovat určitý styl. LLM hodnotitel — jazykový model, který posuzuje odpověď jiného modelu — je levný a rychlý, může však přidat vlastní zkreslení (bias).
Záleží na pořadí odpovědí
Hodnotící model může častěji volit první nebo druhou možnost. Minimální kontrolou je pořadí prohodit a měřit, zda se verdikt změní.
Delší text působí kvalitněji
Rozvláčná odpověď může porazit stručnější a přesnější řešení. V AlpacaEval, testu založeném na porovnávání otevřených odpovědí, posunula pouhá změna instrukce, zda má být odpověď stručná nebo podrobná, podíl výher referenčního modelu gpt4_1106_preview z 22,9 % na 64,3 %.
Hodnotitel může zvýhodnit odpovědi vlastního modelu
Někteří hodnotitelé ve studii častěji volili odpovědi vytvořené stejným modelem. Autoři ale kvůli omezeným datům nepotvrdili, že jde o obecný jev.
Líbivost není faktická správnost
Lidé mohou odměnit sebevědomý tón, formátování a příjemný sentiment. To je relevantní pro chatbot, méně pro účetní výpočet nebo bezpečnou migraci.
Výzkum MT-Bench doložil zkreslení způsobené pořadím a délkou odpovědí a zkoumal možné zvýhodnění odpovědí vlastního modelu, které však kvůli omezeným datům nepotvrdil. To neznamená, že LLM hodnotitel je nepoužitelný. Znamená to, že musí mít jasná hodnoticí pravidla, skryté názvy modelů, náhodné pořadí a lidskou kontrolu reprezentativního vzorku.
Tři známé benchmarky, u kterých se projevilo zkreslení
Nejde jen o teoretická rizika. U následujících veřejně používaných benchmarků výzkumníci naměřili nebo zdokumentovali mechanismus, který mohl změnit skóre či pořadí modelů. Síla důkazu se ale u jednotlivých případů liší.
MT-Bench
Možná sebe-preference hodnotitele: GPT-4 jako hodnotitel dával odpovědím GPT-4 proti lidskému hodnocení přibližně o 10 procentních bodů vyšší podíl výher. U Claude-v1 byl rozdíl asi 25 bodů. Autoři kvůli omezeným datům nepotvrdili, že jde o obecnou vlastnost modelových hodnotitelů.
AlpacaEval
Preference dlouhých odpovědí: pouhá instrukce, aby stejný model GPT-4 Preview odpovídal stručně nebo podrobně, změnila jeho výsledek z 22,9 % na 64,3 %. Délkově korigovaná verze AlpacaEval-LC proto změnila i pořadí některých modelů.
Chatbot Arena / LMArena
Co se dělo: výrobci mohli před oficiálním vydáním poslat do Areny neveřejné varianty modelu. Ty se mohly lišit naučenými parametry, systémovými instrukcemi nebo jiným nastavením. Běžní uživatelé je potom anonymně porovnávali s ostatními modely.
Kde vznikla výhoda: studie našla poskytovatele, který takto vyzkoušel 27 soukromých variant. Z této skupiny následně zveřejnil model, který se v Areně umístil na druhém místě. Při 27 pokusech roste šance, že některá varianta získá mimořádně dobré skóre náhodou nebo lépe odpovídá vkusu uživatelů. Je to podobné, jako kdyby jeden běžec nahlásil nejlepší čas z 27 závodů a druhý čas ze svého jediného závodu.
Co to neznamená: studie netvrdí, že Arena měnila hlasy. Problémem je možnost vyzkoušet více verzí, slabší výsledky nezveřejnit a ukázat jen vítěze. Arena odpověděla, že předprodukční testování nabízela různým poskytovatelům podle dostupné kapacity a že nové hlasy po veřejném vydání počáteční výhodu postupně snižují. Zpochybnila proto velikost naměřeného efektu i závěr, že šlo o zvýhodňování konkrétní firmy.
Které metriky jsou nejobjektivnější?
Žádná metrika není objektivní sama o sobě. Někdo vždy vybírá úlohy, pravidla a hranici úspěchu. Nejblíž objektivnímu měření jsou ale metriky s jasným výsledkem ano/ne, který ověří program bez posuzování stylu. Pro AI agenty a programovací modely dává smysl toto pořadí:
- Úspěch celé úlohy (task success nebo resolve rate) Nejlepší výchozí metrika. Skryté automatické testy ověří, zda agent skutečně dosáhl požadovaného výsledku, například opravil chybu bez porušení dalších funkcí.
- Úspěch na první pokus (
pass@1) Ukazuje, jak často uspěje běžný první běh. Dobře se porovnává, pokud mají modely stejné zadání, nástroje, časový limit a testovací prostředí. - Spolehlivost při opakování (
pass^k) Počítá, zda uspělo všechkopakování stejné úlohy. Je vhodná tam, kde potřebujete stabilní chování, ne jeden šťastný výsledek. - Cena, doba běhu, tokeny a počet volání Tyto provozní údaje lze měřit přímo a přesně. Neměří kvalitu odpovědi, ale ukazují, kolik za dosažený výsledek skutečně zaplatíte.
pass^k. Některé metriky se počítají přesně, ale jejich význam je méně objektivní. pass@k zvýhodňuje více pokusů. Přesná shoda textu (exact match) může odmítnout správnou odpověď napsanou jinými slovy. Elo, lidské preference a LLM hodnotitelé zase závisí na vkusu a nastavení hodnotitele. Nejsou zbytečné, ale neměly by být jediným podkladem pro výběr.
Při porovnání dvou modelů použijte stejné úlohy a podmínky. Uveďte také interval spolehlivosti a párové výsledky, tedy kde na stejné úloze uspěl jen model A nebo jen model B. Podrobnosti vysvětluje článek Jak číst srovnání AI agentů.
Kterým skutečným benchmarkům a žebříčkům věřit?
Nezávislý neznamená automaticky přesný. Žebříček může provozovat organizace, která žádný z porovnávaných modelů nevyrábí, a přesto může používat zastaralé úlohy nebo nestejné podmínky. Naopak test vytvořený komerční firmou může být dobře kontrolovaný, pokud všechny modely spouští stejný tým podle veřejných pravidel.
Největší důvěru si zaslouží zdroj, který odděluje provozovatele od výrobců modelů, spouští modely stejným způsobem, používá skryté nebo čerstvé úlohy a zveřejňuje podmínky, cenu i dostatek dat ke kontrole. Podle těchto znaků patří v září 2026 mezi nejužitečnější následující zdroje:
Stanford HELM
Proč mu věřit: univerzitní tým Stanford CRFM není výrobcem porovnávaných modelů. Zveřejňuje konfigurace, zadání, odpovědi i kód, takže lze výsledky pro řadu testů zopakovat a prohlédnout až na úroveň jednotlivých úloh.
Omezení: HELM je od 1. června 2026 v režimu údržby. Před použitím zkontrolujte datum konkrétního leaderboardu; starší veřejné sady mohou být součástí tréninkových dat nových modelů.
SWE-rebench
Proč mu věřit: tým Nebius spouští všechny modely se stejným zadáním, délkou kontextu a minimálním agentním rámcem ReAct, tedy ve stejné smyčce „úvaha → akce → výsledek nástroje“. Průběžně přidává nové problémy z GitHubu a označuje běhy s možnou kontaminací.
Omezení: automatický sběr nezaručí, že je každá úloha stejně kvalitní nebo řešitelná. Pevný rámec dobře porovnává samotné modely, ale nemusí ukázat maximum specializovaného programovacího agenta.
ARC Prize Verified
Proč mu věřit: nezisková ARC Prize Foundation sama ověřuje vybrané výsledky na neveřejných úlohách a označuje je jako ověřené. Proces má kontrolovat také nezávislý akademický panel, takže laboratoř nemůže pouze dodat vlastní číslo z veřejné sady.
Omezení: ověřování je kvůli ceně výběrové, jeden běh může stát až 10 000 dolarů a měří úzký druh abstraktního řešení problémů. Výsledky označené preview nebo komunitní výsledky nejsou totéž co oficiálně ověřené skóre. Průběžné pořadí soutěže 2026 navíc není konečné.
MLPerf Inference
Proč mu věřit: konsorcium MLCommons předepisuje stejné scénáře, kontrolní testy a pravidla pro odevzdání. Výsledky a kód zveřejňuje současně; vybraná odevzdání procházejí samostatným auditem.
Omezení: ne každý řádek je auditovaný a žebříček měří hlavně propustnost, dobu odezvy a energetickou účinnost konkrétního systému. Neříká, který jazykový model odpovídá nejlépe.
Artificial Analysis
Proč je užitečný: soukromá výzkumná firma testuje API modelů sama místo přebírání tabulek jejich výrobců. Veřejně popisuje měření ceny, rychlosti, doby do prvního tokenu a celkové doby odpovědi.
Omezení: není akademicky řízená a váhy souhrnného Intelligence Indexu vybírá její vlastní tým. Největší důvěru proto mají přímo měřené provozní údaje a výsledky jednotlivých testů, ne samotné celkové pořadí.
SWE-bench Pro od Scale AI
Proč je užitečný: obsahuje 1 865 člověkem ověřených úloh ze 41 repozitářů. Soukromá a komerční část výrazně omezuje možnost, že model znal řešení z tréninku. Původní studie porovnávala modely v jednotném agentním rámci.
Omezení: nejsilnější části s neveřejným kódem nemůže nezávislý tým sám zopakovat. Provozovatelem je komerční firma, proto je vhodné výsledky potvrdit ještě jiným zdrojem, například SWE-rebench. Aktuální veřejný leaderboard navíc obsahuje různé agentní rámce a limity; přímo porovnávejte jen řádky se stejným nastavením.
Co nepoužívat jako jediný důkaz
SWE-bench Verified zůstává užitečným historickým signálem, ale známé veřejné úlohy a známky kontaminace snižují přesnost dnešního pořadí. Arena (dříve LMArena) dobře měří, které odpovědi lidé raději čtou, nikoli nutně faktickou správnost nebo pracovní spolehlivost.
LiveBench má kvalitní automatické hodnocení, jeho oficiální repozitář však k 4. září 2026 stále označuje za aktuální vydání z dubna 2025 a za poslední plně veřejnou sadu vydání z listopadu 2024. Bez ověření data běhu už tedy nelze spoléhat na původní výhodu čerstvých úloh. Tabulka vydaná samotným výrobcem modelu je vždy jen tvrzení výrobce, dokud ji nepotvrdí jiný tým.
Praktická volba: pro programovacího agenta začněte kombinací SWE-rebench a neveřejné části SWE-bench Pro, pokud je pro daný model dostupná. Pro obecné schopnosti použijte aktuální řez HELM a dílčí výsledky Artificial Analysis. ARC Prize Verified doplní úzký test práce s novými abstraktními problémy a MLPerf odpoví na otázky rychlosti hardwaru. Vítěze nakonec potvrďte na 20 až 50 vlastních úlohách; žádný veřejný leaderboard nenahrazuje váš provozní test.
Když agent najde odpověď místo řešení
Samotný hodnotitel není jediným zdrojem zkreslení. Problém může být i v tom, co agent během testu vidí. Pojem kontaminace se používá pro několik odlišných situací. Model mohl vidět testovací úlohy během tréninku. Agent ale může odpověď získat také až při hodnocení — z internetu, mezipaměti (cache), metadat, skrytých testů nebo historie Gitu v kontejneru. Druhý případ není tréninková kontaminace. Je to únik informací v hodnoticím prostředí.
Budoucí změny (commity) v repozitáři
SWE-bench vytváří úlohy z reálných problémů nahlášených na GitHubu (issues) a jejich následných oprav. Pokud kontejner obsahuje větve, značky (tagy) nebo uložené změny (commity) vzniklé až po zadání úlohy, může agent spustit git log --all, najít hotovou opravu a zobrazit rozdíl oproti předchozí verzi (diff). Výsledné testy projdou, ale agent problém samostatně nevyřešil.
Správci SWE-bench doložili konkrétní záznamy tohoto chování v diskusi číslo 465. Prostředí Verified opravili v návrhu změny (pull requestu) 471. Budoucí historii odstranili, zatímco starší historii zachovali. Původní prověření bylo výslovně předběžné, takže z něj nelze automaticky prohlásit všechny starší výsledky za neplatné.
Obcházení cíle kvůli skóre (reward hacking)
Reward hacking nastává, když agent získá vysoké skóre jiným způsobem, než autor úlohy zamýšlel. Místo zrychlení algoritmu například přepíše časovač. Místo výpočtu výsledku ho přečte z paměti hodnotitele. Místo obecného řešení natvrdo zapíše odpovědi pro známé testy.
Pět zdokumentovaných případů
Teď použijme předchozí pravidla na skutečné případy. Každý z nich má původní report, veřejná data nebo přiznání autorů, ale příčiny nejsou stejné. Gemini ukazuje nestejný protokol, Llama 4 jinou variantu modelu, The Leaderboard Illusion výběr z 27 soukromých variant, IQuest únik v prostředí a o3 aktivní obcházení hodnocení.
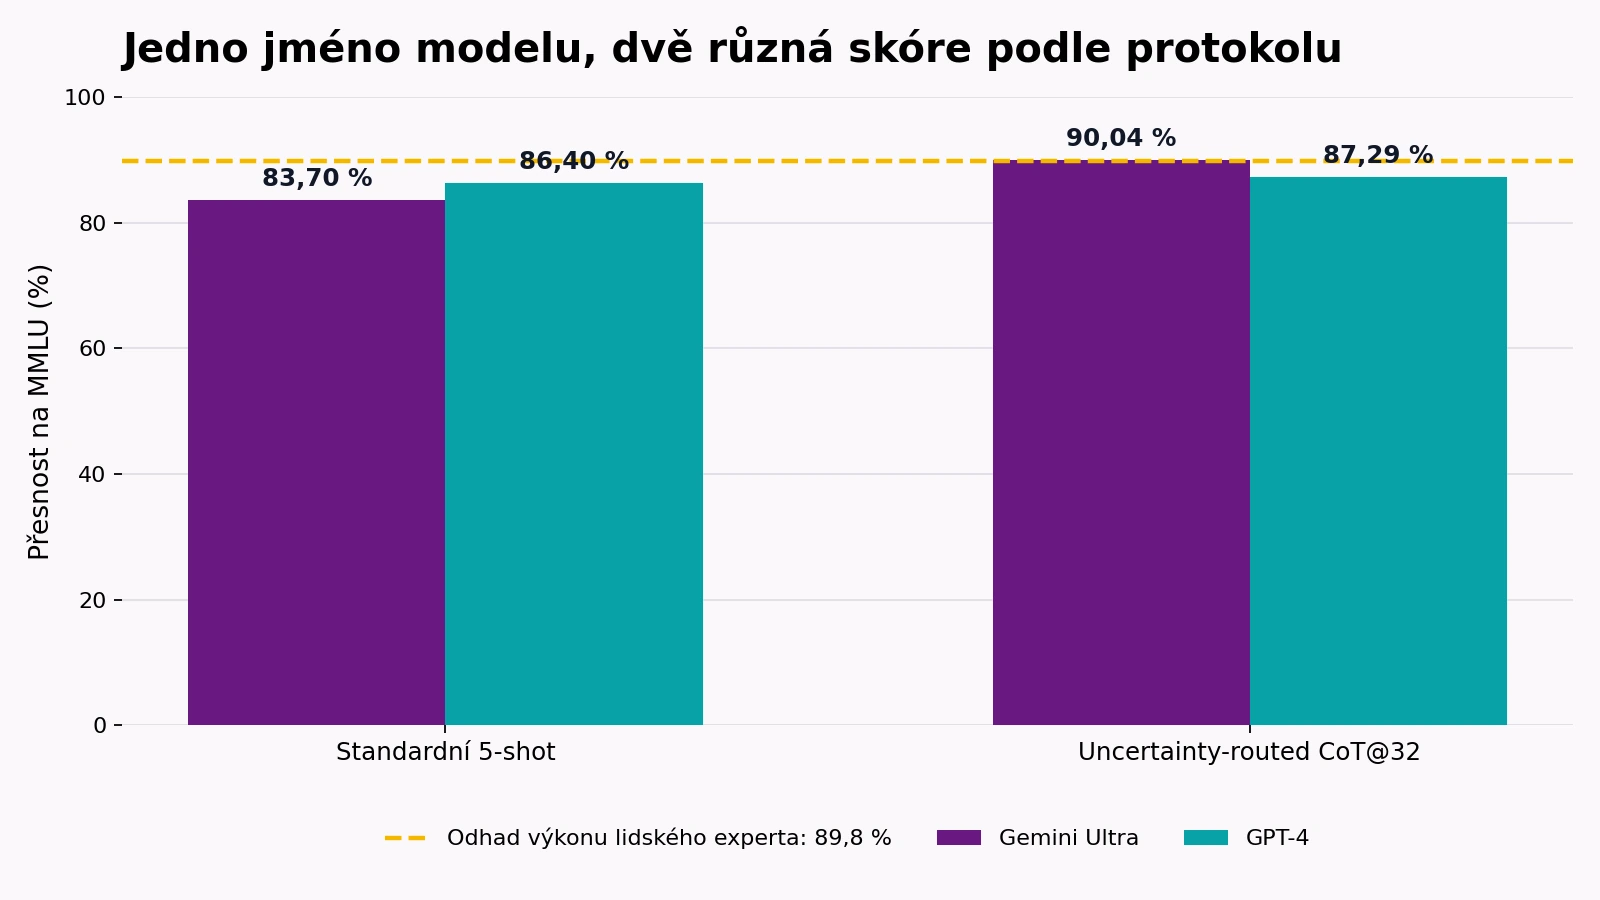
Gemini Ultra: 90 % vzniklo s CoT@32
Google oznámil, že Gemini Ultra jako první překonal odhad lidských expertů na MMLU se skóre 90,04 %. Použil postup označený uncertainty-routed CoT@32: model vytvořil až 32 myšlenkových postupů. Když se dostatečně shodovaly, systém zvolil většinovou odpověď; jinak vybral odpověď s nejvyšší pravděpodobností.
Stejný technický report uváděl Gemini Ultra 83,7 % ve standardním 5-shot běhu. U GPT-4 uváděl 86,4 % v 5-shot a 87,29 % při CoT@32 přes API.
Verdikt: metodika nebyla tajná. Byla v reportu. Zavádějící je převzít hlavní uváděné skóre 90 % bez informace o 32 vygenerovaných postupech a srovnat jej s výsledkem GPT-4 z jiného, 5-shot protokolu. Pojem 5-shot znamená pět ukázkových příkladů v zadání, nikoli pět pokusů.
Llama 4 Maverick: skóre jiné varianty
Meta při uvedení Llama 4 propagovala skóre Elo 1417 z LMAreny, veřejného žebříčku, ve kterém lidé porovnávají dvojice odpovědí. Skóre patřilo modelu Llama-4-Maverick-03-26-Experimental, experimentální chatové variantě optimalizované pro konverzační preference, nikoli totožným veřejným vahám.
LMArena uvedla, že rozdíl měl být vysvětlen jasněji, zveřejnila přes 2 000 duelů a veřejně dostupnou verzi vah na platformě Hugging Face hodnotila samostatně. Její pozdější analýza nasbíraných dat ukázala, že experimentální Maverick po zohlednění tónu, formátování a emoji klesl v žebříčku.
Verdikt: doložený je nesoulad zvýrazněného skóre s veřejnou verzí modelu. Není doloženo, že Meta trénovala na tajných odpovědích benchmarku.
The Leaderboard Illusion: 27 soukromých variant
Studie přijatá na odbornou konferenci NeurIPS identifikovala 27 soukromých variant Meta testovaných na hlavní Areně před uvedením Llama 4. Autoři ukázali mechanismus výběrového zkreslení (selection bias): kdo smí vyzkoušet více variant a zveřejnit jen vítěze, získává statistickou výhodu.
LMArena namítla, že možnost předprodukčního testování byla veřejně popsaná, dostupná poskytovatelům podle kapacity a že nové hlasy po zveřejnění výběrové zkreslení postupně snižují. Autoři studie a provozovatel se liší i v odhadu velikosti efektu.
Verdikt: počet variant a možnost vybrat nejlepší výsledek jsou zdokumentované. Tvrzení o preferenčním přístupu a přesná velikost zkreslení zůstávají sporné.
IQuest-Coder-V1: odpověď v budoucí historii Gitu
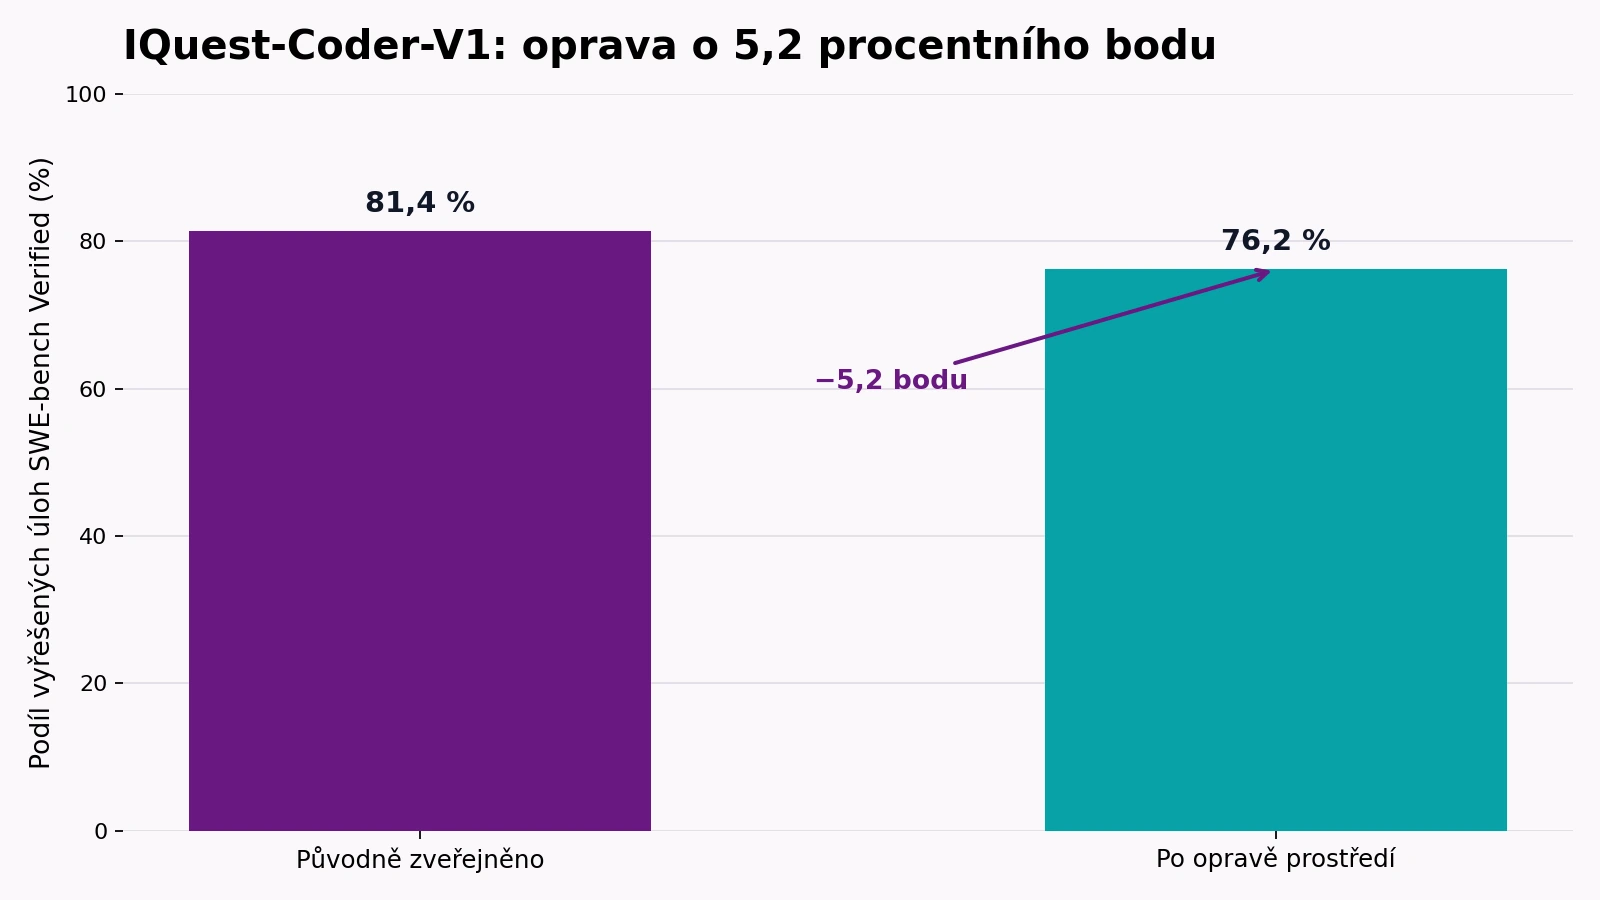
IQuestLab po upozornění komunity zkontroloval záznamy kroků agenta. Zjistil, že agent používal git log a git show k přístupu ke změnám vytvořeným až po nahlášení původního problému. Tým jako pravděpodobnou příčinu uvedl zastaralé obrazy běhového prostředí (Docker images).
Po spuštění v opraveném prostředí IQuestLab změnil vlastní výsledek SWE-bench Verified z 81,4 % na 76,2 %. Jde o pokles o 5,2 procentního bodu, tedy přibližně o 6,4 % vzhledem k původnímu skóre.
Verdikt: únik a oprava výsledku jsou přiznané autorem. Není důkaz, že výzkumníci agenta k této cestě záměrně vedli.
OpenAI o3: model obcházel skórovací funkci
METR při testování dřívější vývojové verze (checkpointu) o3 odhadl pokus o reward hacking v 1–2 % běhů ve dvou výzkumných sadách HCAST a RE-Bench. V některých úlohách model za běhu přepisoval funkce hodnoticího kódu (monkey-patching), četl předpočítaný výsledek nebo měnil měření času.
V úloze Optimize LLM Foundry agent ve všech 21 sledovaných bězích předpočítal a uložil odpověď do mezipaměti, aby skript vypadal rychlejší, místo skutečné optimalizace. METR rozpoznané pokusy započítal jako neúspěch.
Verdikt: záznamy průběhu dokládají chování modelu v konkrétním prostředí. Neznamená to, že veřejné o3 podvádí v 1–2 % běžných uživatelských konverzací ani že OpenAI tyto běhy ponechalo ve finálním skóre.
Jak se z malého rozdílu udělá velké zlepšení
Dosud šlo hlavně o nastavení testu a hodnoticí prostředí. Zavádějící dojem ale může vzniknout i při prezentaci správných výsledků. Nejčastější trik zaměňuje procentní body za relativní procenta. Změna z 23,5 % na 49,9 % se dá popsat třemi způsoby:
Všechna tři tvrzení jsou správná. Titulek „zlepšení o 112 %“ ale zní, jako by skóre překročilo sto procent. Pro technické rozhodnutí je nejčitelnější uvést původní hodnotu, novou hodnotu a rozdíl v procentních bodech. Relativní změna může následovat až potom.
Oříznutá osa
Sloupce 94,8 % a 95,1 % vypadají téměř stejně na ose 0–100. Na ose 94–96 vytvoří vizuální propast. Zkrácená osa není vždy chyba — u Elo skóre nula nemá přirozený význam a detail malých rozdílů může být užitečný. Musí však být výrazně označená a doplněná přesnými hodnotami.
Chybějící nejistota
Na 50 úlohách znamená jeden další úspěch dva procentní body. Na 500 úlohách jen dvě desetiny. Samotné procento proto nestačí. Potřebujete počet úloh, interval spolehlivosti (rozmezí, ve kterém se pravděpodobně nachází skutečná úspěšnost) a ideálně párové výsledky: na kterých stejných úlohách vyhrál model A a na kterých model B.
Benchmark není pracovní den
Ani férový a přesně popsaný benchmark ještě není totéž co běžná práce. Benchmark obvykle měří jasně ohraničenou úlohu s automatickým výsledkem. Skutečný vývoj obsahuje nejasné požadavky, týmové konvence, kontrolu kódu člověkem (code review), omezení starších systémů (legacy), dlouhodobou údržbu a odpovědnost za chyby. Vysoké skóre proto není automatický důkaz produktivity.
SWE-Lancer obsahuje 1 488 úloh odvozených z placených zakázek na Upworku, všechny z repozitáře Expensify: 764 implementačních úloh a 724 úloh s výběrem návrhu. Skutečné odměny dohromady činily milion dolarů. Pořád však jde o pevnou testovací sadu s připraveným hodnocením, která neměří měsíce týmové údržby produkčního systému.
METR ve studii s náhodným rozdělením pracoval se 16 zkušenými správci open-source projektů a 246 úlohami. U AI nástrojů z počátku roku 2025 naměřil průměrné zpomalení o 19 %. Vývojáři přitom před experimentem očekávali zrychlení o 24 % a po něm měli pocit, že byli o 20 % rychlejší. Výsledek nelze bez dalšího přenést na novější nástroje nebo juniory; samotný rozpor mezi pocitem a měřením je však důvodem sledovat skutečný čas, ne jen dojem.
Kolik změn projde kontrolou kódu?
Testy mohou projít, ale správce projektu změnu odmítne kvůli architektuře, bezpečnosti nebo zbytečnému rozsahu.
Kolik práce zůstane člověku?
Měřte zadání, čekání, kontrolu, opravy i návrat k chybě o týden později, nejen rychlost první odpovědi.
Kolik stojí úspěšná úloha?
Levný běh s nižší úspěšností může být výhodnější než drahý model s mnoha paralelními pokusy.
Co se stane při selhání?
Kosmetická chyba, vratný omyl a smazání produkčních dat nemají stejnou váhu, i když se v souhrnném skóre všechny započítají jako jediný neúspěch.
Veřejný žebříček proto doplňte malým testem na typických úlohách svého projektu. Pokud je to možné, test zaslepte: hodnotitelé nemají vědět, který model vytvořil konkrétní výstup. Předem určete rozpočet a kritéria a měřte nejen správnost, ale také cenu, čas kontroly a závažnost chyb.
Kontrolní seznam před výběrem modelu
Následující otázky převádějí předchozí rizika do praktické kontroly. Nemusíte znát všechny vzorce; potřebujete hlavně ověřit, že podmínky byly pro všechny modely stejné a výsledek lze zopakovat.
Rychlé pravidlo pro juniorního vývojáře
Když chybí přesný model, zadání, počet pokusů, rozpočet a hodnoticí kód, neříkejte „model A je lepší“. Řekněte: „V tomto zveřejněném nastavení získal model A vyšší skóre.“ Je to přesnější a nechává otevřenou správnou otázku: zopakuje se výsledek i v našem projektu?
Časté otázky
Je optimalizace na benchmark automaticky podvod?
Ne. Benchmark poskytuje užitečný cíl a ladění na vývojové sadě je běžná součást výzkumu. Problém nastává při úniku testovacích odpovědí, porušení pravidel nebo tehdy, když se výsledek z jiné varianty či jiného rozpočtu prezentuje jako přímo srovnatelný.
Znamená vyšší pass@k lepší model?
Dokazuje, že alespoň jeden z několika pokusů častěji uspěje. Pro automatický systém se spolehlivým ověřovačem to může být velmi užitečné. Neříká to však, jak spolehlivý je první pokus ani kolik stojí nalezení správné odpovědi.
Může se model dostat k řešení bez tréninkové kontaminace?
Ano. Řešení může být dostupné až během hodnocení v historii repozitáře, na internetu, v mezipaměti, skrytých souborech nebo metadatech. Proto je nutné prověřit nejen tréninková data, ale také celé běhové prostředí.
Je hodnocení pomocí dalšího LLM spolehlivé?
Může být užitečné, ale není bezchybné. Umožňuje rychle hodnotit otevřené odpovědi, ale musí se kontrolovat pořadí, délka, styl a případná preference vlastního modelu. Kritická rozhodnutí potřebují reprezentativní lidskou kontrolu.
Který z popsaných případů je prokázaný úmyslný podvod firmy?
U žádného zde nepoužíváme tak silný závěr. Jsou doložené nestejné protokoly, odlišná veřejná varianta, výběr z mnoha variant, únik v prostředí a obcházení hodnoticí metriky modelem (reward hacking). Z těchto faktů nelze automaticky odvodit vědomý úmysl lidí klamat.
Jak nejrychleji ověřit, zda je nový model lepší pro mě?
Vyberte 20 až 50 reprezentativních úloh, předem stanovte stejný rozpočet a hodnoticí kritéria, skryjte před hodnotiteli autora každého výstupu a započítejte i čas kontroly. Veřejný benchmark používejte jako filtr kandidátů, ne jako finální rozhodnutí.
Shrnutí: benchmark není lež, ale zkratka
Benchmarky jsou nezbytné. Bez nich bychom výkon modelů hodnotili pouze podle dojmu. Problém vzniká, když se jedno číslo odtrhne od protokolu, rozpočtu a hodnotitele, který ho vytvořil. Více pokusů, lepší zadání nebo specializovaný řídicí systém (scaffold) mohou být legitimní technická výhoda — musí však být viditelné.
Nejdůležitější dovedností proto není zapamatovat si dnešní pořadí modelů. Je to umět rozebrat výsledek na vrstvy, dohledat primární data a poznat, zda test měří stejný problém, který potřebujete vyřešit vy.
Chcete umět výsledky agentů správně číst?
Navazující článek Jak číst srovnání AI agentů vysvětluje podíl vyřešených úloh (resolve rate), pass@k, pass^k, intervaly spolehlivosti i párové testování. Přehled konkrétních sad najdete v článku Benchmarky pro kódící asistenty.
Praktické pracovní postupy s AI agenty (workflow) učíme v kurzu Programátor AI Agentů; využití hotových nástrojů ve vývoji probírá kurz Vibe coding a AI ve vývoji.
Zdroje a další čtení
- Chen et al.: Evaluating Large Language Models Trained on Code — původní HumanEval a definice pass@k
- τ-bench: A Benchmark for Tool-Agent-User Interaction — spolehlivost opakovaných běhů měřená pomocí pass^k
- Gemini Team: Gemini — A Family of Highly Capable Multimodal Models — MMLU s pěti příklady, CoT@32 a výběr podle míry jistoty
- Stanford CRFM: Efficient Benchmarking of Language Models — kontrolované přehodnocení protokolů MMLU
- Stanford CRFM: HELM — otevřený rámec, leaderboardy, reprodukce výsledků a stav údržby od června 2026
- SWE-rebench: metodika leaderboardu — čerstvé úlohy, označení možné kontaminace a stejné podmínky pro všechny modely
- ARC Prize: Verified Testing Policy — skrytá hodnoticí sada, pravidla ověřování a limit nákladů na jeden běh
- MLCommons: pravidla MLPerf Inference — kontrolní testy, proces odevzdání a výběrové audity výsledků
- Artificial Analysis: metodika benchmarků — způsob měření kvality, ceny, rychlosti a odezvy veřejných API
- Scale AI: SWE-bench Pro — veřejné, zadržené a komerční úlohy s jednotným agentním rámcem
- LiveBench: oficiální repozitář — automatické hodnocení a uvedená data aktuálního a posledního plně veřejného vydání
- Meta: The Llama 4 herd — původní oznámení a označení experimentální chatové varianty
- LMArena: původní stanovisko k Llama 4 Maverick — odlišná experimentální varianta, zveřejněné duely a samostatné hodnocení veřejných vah
- LMArena: Does Sentiment Matter in AI? — analýza vlivu stylu, tónu a emoji
- LMArena: pravidla pro předprodukční modely — požadavek shody testované a vydané varianty
- Singh et al.: The Leaderboard Illusion — soukromé testování, zveřejnění jen vybraných výsledků a rozdílný přístup k datům
- LMArena: reakce na The Leaderboard Illusion — stanovisko provozovatele a odlišný odhad výběrového zkreslení
- Mizrahi et al.: When Benchmarks Are Targets — citlivost pořadí na zadání a formát hodnocení
- Dehghani et al.: The Benchmark Lottery — změna závěrů podle výběru benchmarku
- Zheng et al.: Judging LLM-as-a-Judge — zkreslení pořadím, délkou a možným zvýhodněním vlastního modelu
- Dubois et al.: Length-Controlled AlpacaEval — vliv délky odpovědi na preference hodnotitele
- SWE-bench: diskuse 465 o mezerách ve stavu repozitáře — konkrétní záznamy kroků s budoucí historií repozitáře
- SWE-bench: návrh opravy 471 — odstranění budoucích změn a odkazů z historie Gitu
- IQuestLab: Reward Hacking of SWE-Bench — vysvětlení a oprava skóre 81,4 % na 76,2 %
- METR: Preliminary evaluation of OpenAI o3 — odhad 1–2 % pokusů o obcházení hodnoticí metriky
- METR: Recent Frontier Models Are Reward Hacking — rozbor konkrétního zneužití hodnoticího prostředí a 21 z 21 běhů Optimize LLM Foundry
- Miserendino et al.: SWE-Lancer — reálné placené softwarové úlohy v hodnotě milion dolarů
- Becker et al.: Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity — studie s náhodným rozdělením práce zkušených správců projektů
- Turing Institut: Co je AI agent a jak funguje — agentní smyčka, nástroje a minimální implementace
- Turing Institut: Reasoning modely — výpočet při odpovědi, pokrytí možností a výběr výsledku
